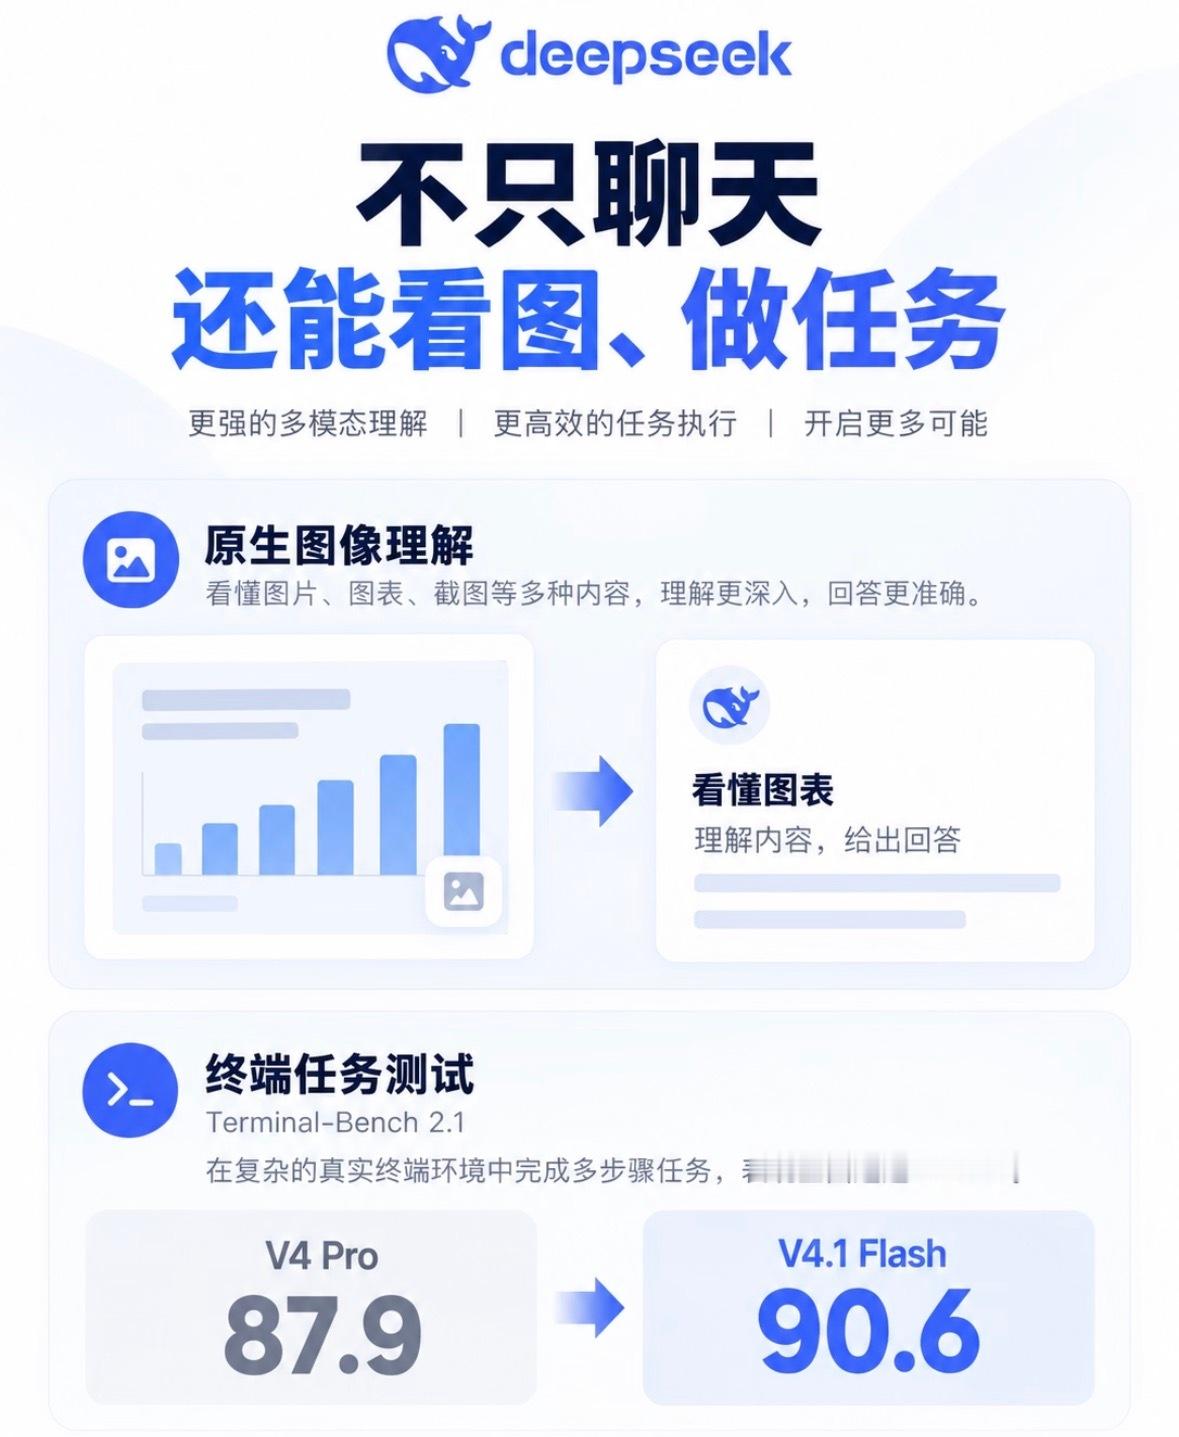
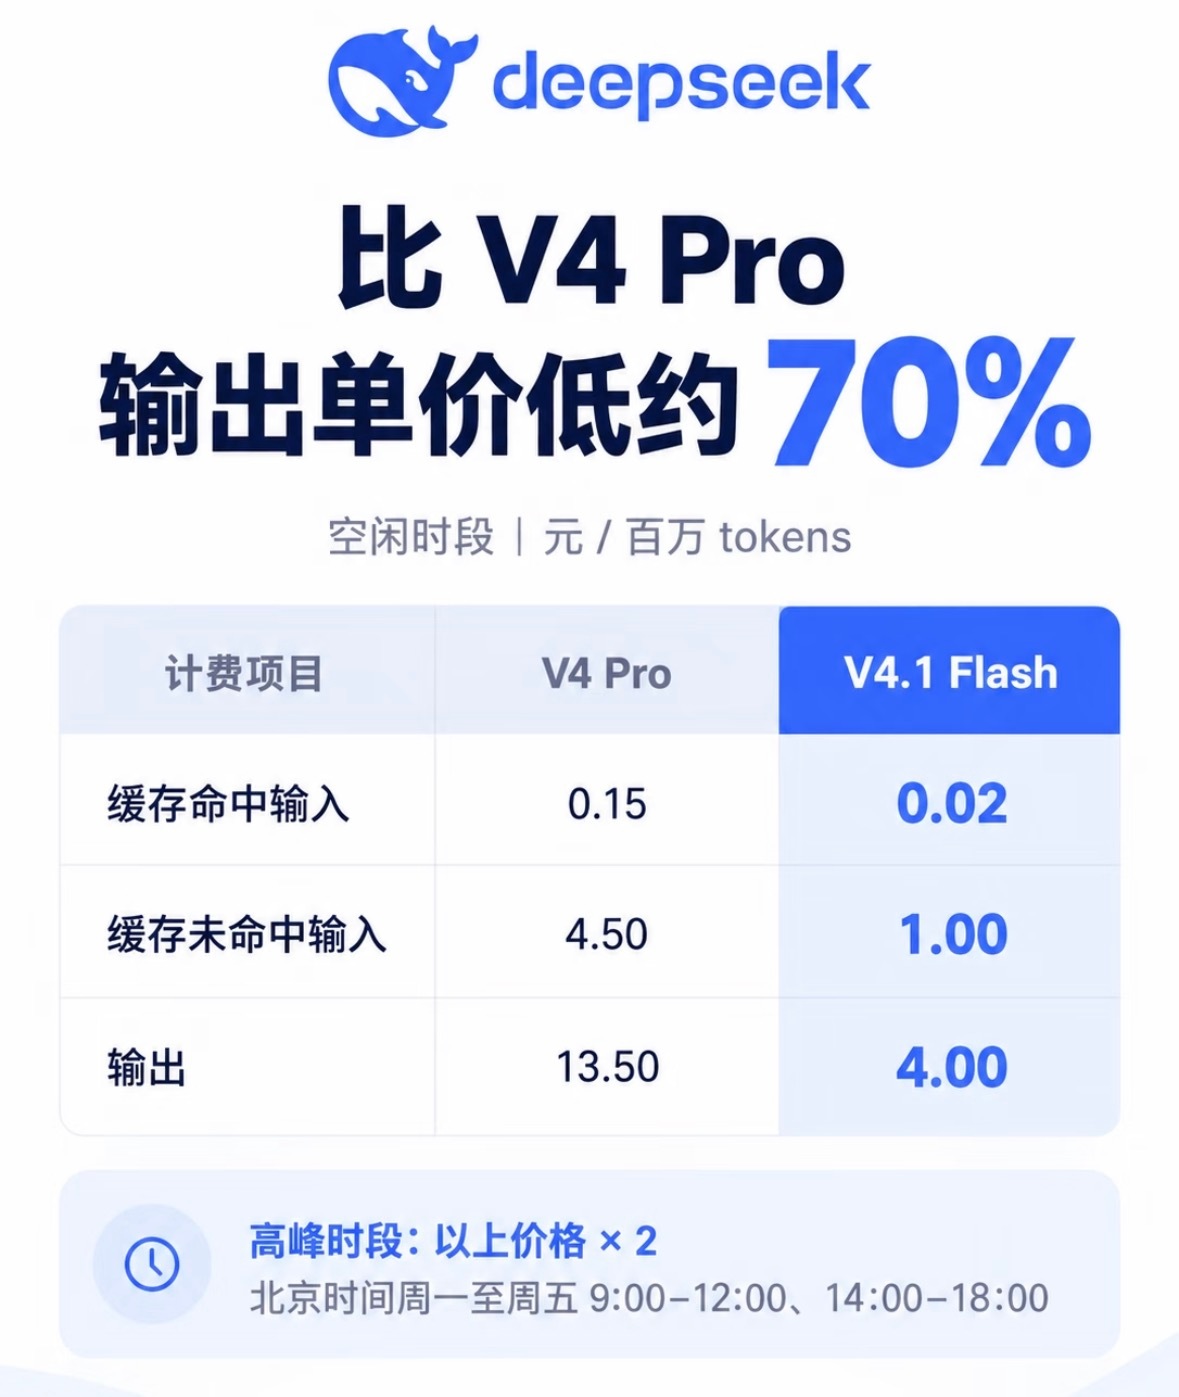
DeepSeekV4.1Flash发布这次 DeepSeek V4.1 Flash 发布,感觉戳中了行业一个痛点:大模型不是参数堆越高越好,激活开销、显存占用才是落地瓶颈。552B 的 MoE,激活量控制得非常克制,KV Cache 对比初代直接缩到 1/437。显存、存储需求双双下降,算力门槛持续下探。当超大模型不再被硬件卡住,整个应用生态的想象空间都会打开。DeepSeekV4.1Flash发布

DeepSeekV4.1Flash发布这次 DeepSeek V4.1 Flash 发布,感觉戳中了行业一个痛点:大模型不是参数堆越高越好,激活开销、显存占用才是落地瓶颈。552B 的 MoE,激活量控制得非常克制,KV Cache 对比初代直接缩到 1/437。显存、存储需求双双下降,算力门槛持续下探。当超大模型不再被硬件卡住,整个应用生态的想象空间都会打开。DeepSeekV4.1Flash发布