为什么腾讯放着华为昇腾芯片不用,却花70亿美元向甲骨文东南亚数据中心租用10万枚AI芯片?昇腾芯片要是真能用,腾讯为什么不用?昇腾虚假宣传吗?
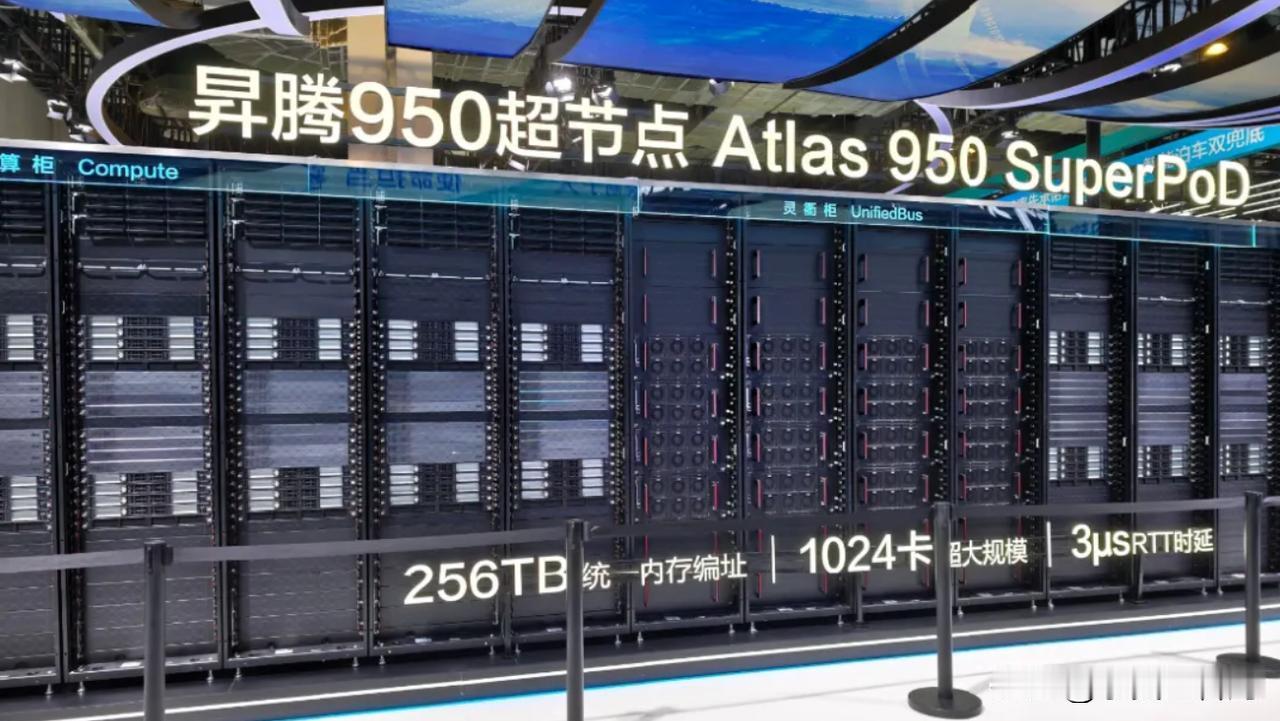
关于这个问题徐直已经讲得很清楚了——产能有限。昇腾950PR主要做推理,但目前有限供应,面向训练的950DT SuperPoD还在测试,大规模供应要到今年年底或者明年年初。
徐直军说,现在限制AI基础设施扩产的,不只是芯片,还包括光模块、存储、光互连这些东西。全球AI需求这几年涨得太快,整个供应链都没准备好,很多光模块和存储产品现在能卖出高溢价,本质就是供不应求。他的判断是,全球AI产业真正做到供需基本平衡,可能要到2029年前后,中国大陆甚至可能更晚。NPO、CPO这些下一代光互连技术,还会继续改变整个供应链结构。
所以昇腾现在面对的问题,更像是一套AI基础设施产能爬坡。
华为海思首席科学家廖恒也说了,昇腾现在最大的障碍不是硬件,而是生态。
CUDA统治AI开发太久了。过去十几年,学术界、算法工程师、模型公司基本都是PyTorch加CUDA一路用过来的。代码、算子、工具链、调试习惯、人才,全绑在这个体系上。
腾讯以前积累的大量训练框架、算子、通信库、工程代码,本来就是围绕英伟达生态开发的。一座已经跑起来的工厂,不会因为另一家设备厂出了新机器,第二天把整条生产线拆掉。
这也是国产AI芯片现在最难的一关,不是芯片不能用,而是CUDA这座软件生态的护城河太深。华为自己一直在补CANN、MindSpore、通信库和开发工具。就在前两天,DeepSeek还宣布与华为合作开发针对昇腾优化的编程工具,把计算库、通信库继续往开源方向推进。要是真完全不能用,产业界不会费这么大劲迁移生态。
华为披露,虽然和英伟达CUDA生态仍有差距,但目前CANN外部开发者占比已经达到61%,基于昇腾+CANN的原生训练模型超过40个,同时已经适配PyTorch、Triton、vLLM等90多个主流社区。
所以腾讯外租10万卡这事,只能证明英伟达芯GPU依然好用,CUDA生态依然成熟,也能说明中国互联网公司现在有多缺算力,恨不得一张卡掰成两半用。
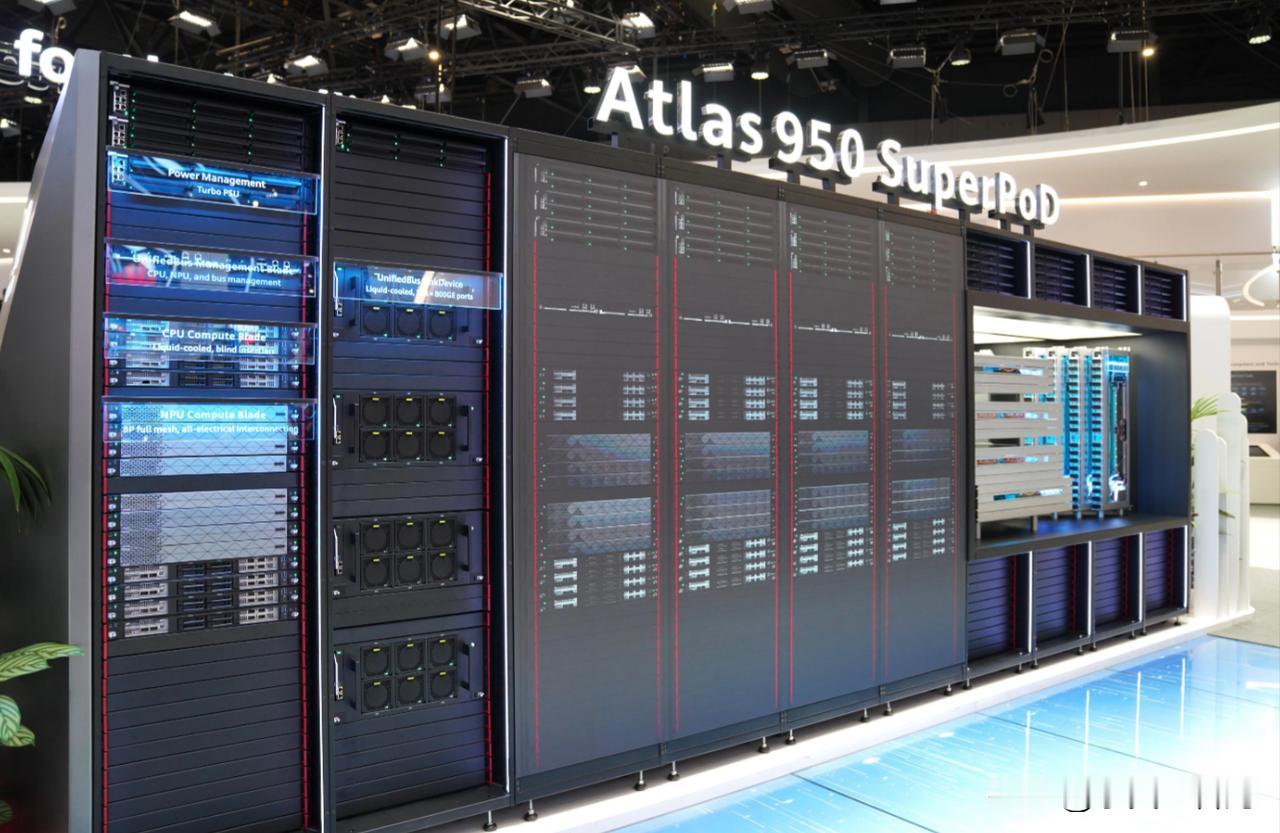
但拿这件事证明昇腾虚假宣传就是胡说八道了,华为今年9月公开披露,基于910C的Atlas 900 A3 SuperPoD已经部署超过1000套,950 SuperPoD也已经进入规模商用。徐直军还披露,昇腾在中国AI芯片市场的份额已经超过英伟达。
用一句话概括昇腾现在的问题: 产能还要爬,生态还要补。至于单卡性能差距,华为现在走的技术路线,本来就不是单卡技术路线,而是通过超节点、高速互连和大规模集群,把单芯片差距尽量从系统层面追回来。
华为昇腾芯片能否替代英伟达? 华为昇腾 算力芯片 华为 英伟达 腾讯 国产芯片