偏好蒸馏:小模型负例更强?
更强的偏好负例,未必来自更大的模型。大模型训练时,正确答案之外,究竟该用什么“错答案”作对照?
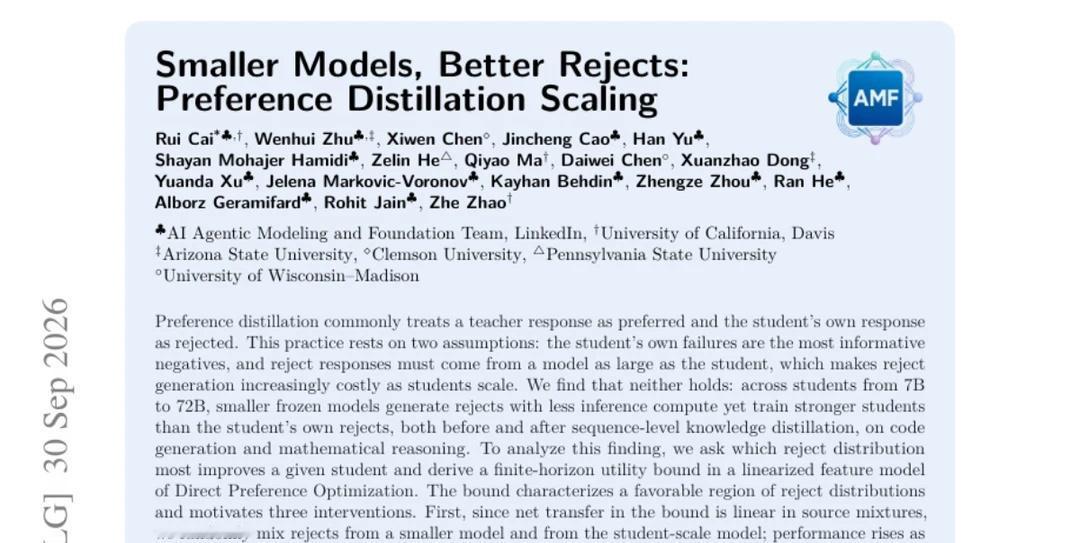
论文《Smaller Models, Better Rejects: Preference Distillation Scaling》研究偏好蒸馏的负例来源。常见做法把教师答案当“优选”,学生自己的错误当“拒绝”。但学生变大,自生成负例更耗算力;经教师示范训练后,学生错误也可能很像自身策略,难以形成有效对比。
作者先用教师可验证答案做序列级蒸馏,再以DPO训练学生;固定提示、优选答案、初始化和预算,只改变拒绝答案来源。测试Qwen2.5的7B至72B学生,评估代码与数学推理;代码负例经单元测试确认至少一项失败。
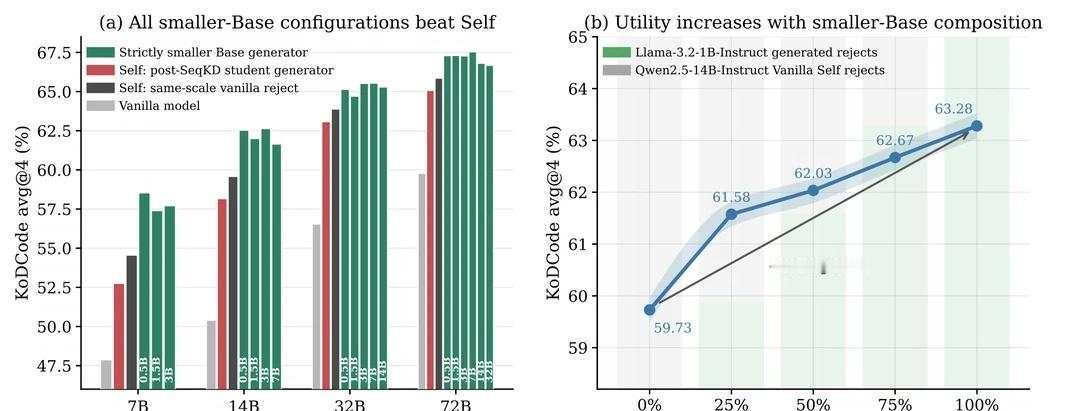
结果反直觉:18种较小基础模型配置在代码avg@4都超过两种学生自拒绝设置。Qwen2.5-3B负例训练14B学生,相比同规模模型自生成,代码提升3.1个百分点、数学1.9点。Llama-1B负例占比从0升至100%,14B学生代码avg@4从59.73%升至63.28%。按参数量与输出长度估算,较小模型生成成本为同规模自生成的0.9%至50.1%;不等同实际账单或时延。
为何错得有用?把代码负例分配给别的题,甚至打乱词元顺序,仍胜过等长乱码,表明代码领域结构能提供信号,不全靠错误和原题一一对应。另在同一候选池挑选参考模型似然较低的负例,通常比挑高似然更有效。作者认为,好负例要保留任务结构,同时避免与当前策略过度重合。
边界是:实证集中在可核验代码、数学,规模主线以Qwen2.5为主;理论基于线性化DPO及有限步条件,不是任意任务保证。我的判断:拒绝样本来源不只是预处理细节。蒸馏关键未必是找到最像学生的错题,而是构造既相关、又有足够差异的对照。实践中可先固定DPO目标与预算,再比较负例来源,并分别报告质量和生成成本。
原标题:Smaller Models, Better Rejects: Preference Distillation Scaling。作者:Rui Cai等。图1:原论文规模与负例混合实验;月榜附图:同论文 Hugging Face 卡片缩略图。 大模型 偏好优化