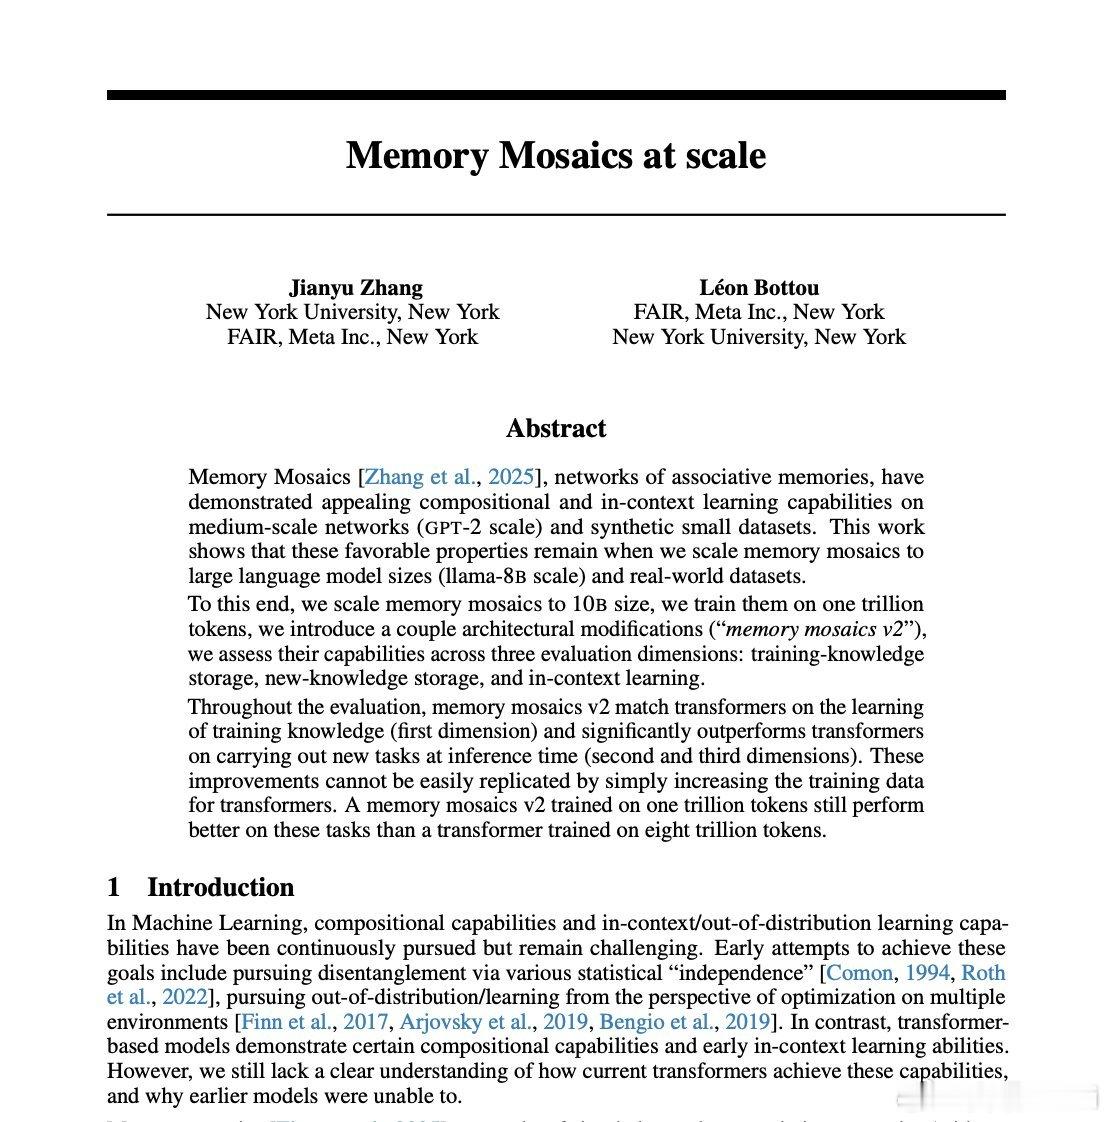
「1万亿token训练出来的模型,打赢了用8万亿token训练的Transformer。」
Meta FAIR和纽约大学(Jianyu Zhang与Léon Bottou合作)把《Memory Mosaics at scale》推到了100亿参数规模——把标准注意力换成一张"联想记忆"网络:该记的东西存成键值对,用到时按需取。Transformer像一台每个token都要从头算一遍的计算器,它更像一个会翻字典的人。
论文实测:在"新知识存储"和"上下文学习"两个维度,1万亿token训练的MM v2,成绩好于8万亿token训练的Transformer;在训练知识存储上两者打平。也就是说,这个差距不是"多喂数据"能补的,是架构层面的。
这件事的意味值得琢磨:从GPT到ChatGPT、Claude、Gemini,主流大模型全建在Transformer上,行业的默认答案是更大的GPU和更多的数据中心。如果"更会记"比"更大"更划算,算力叙事的斜率就要重估——GPU需求和数据中心资本开支都会被这个变量牵动。
冷静一句:100亿参数离前沿模型规模还远,工程化、推理效率、生态迁移都是问号,"终结Transformer时代"言过其实;但"注意力不是唯一解",这次有了十亿参数级加万亿token的实验证据。
你看好非注意力架构吗?
AIMeta大模型Transformer