⭐️欢迎关注新工作 ReAT:用残差反馈组织动作 token,让自回归机器人策略“先有草稿”,再用后续 token 逐步修正。
-论文标题:ReAT: Residual Action Tokenization for Autoregressive Robot Policies
-论文链接:https://arxiv.org/abs/2610.13093
🔎背景与痛点:从动作压缩走向逐步修正
自回归机器人策略需要将连续动作片段转成离散 token。现有方法能重建动作,但每个 token 补充了什么,往往隐含在编解码过程中。压缩与重建精度,并不直接决定策略表现。
💡关键 Insight:下一个 token 应该修正什么?
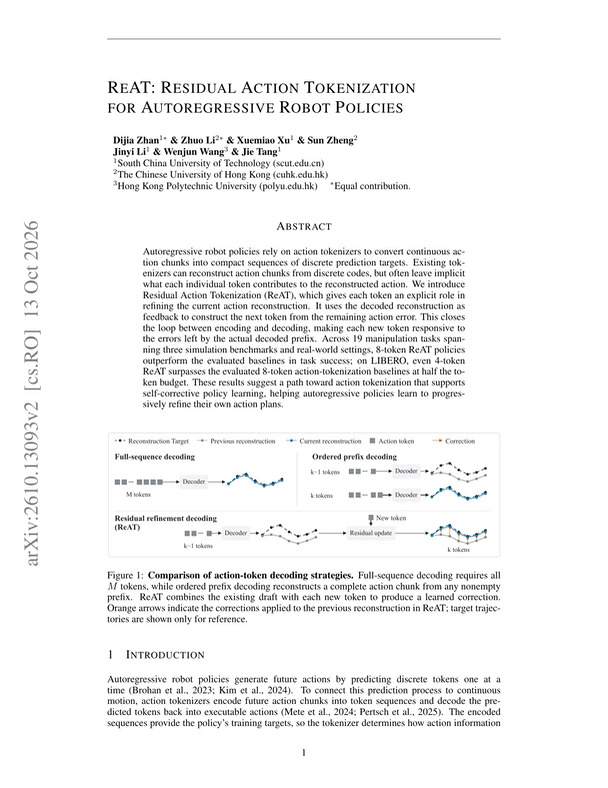
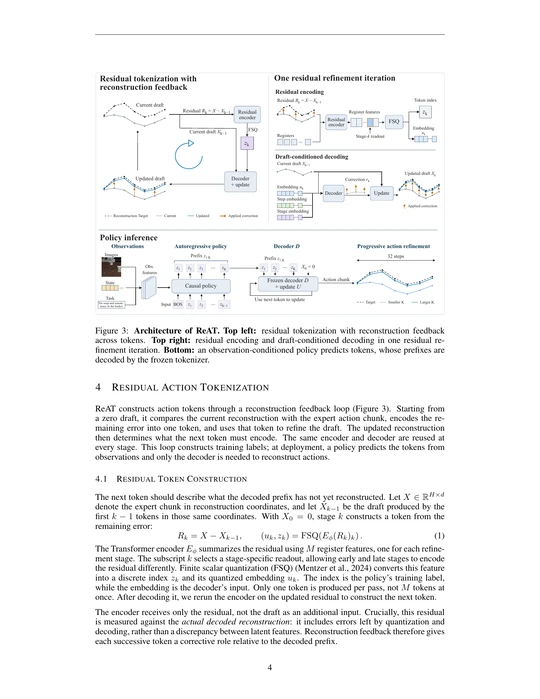
关键在于已经解码出的动作还缺什么。以专家动作与当前重建之间的残差作为下一轮编码输入,就能让每个新 token 针对前缀实际留下的误差,包括量化与解码偏差。
🛠️提出方案: Reconstruct → Compare → Encode → Refine
ReAT 通过三项设计组织动作序列:1)以重建残差反馈构造下一个 token;2)让解码器结合当前动作草稿与新 token,预测修正量;3)对不同长度的前缀进行重建监督,让同一策略无需重训即可使用不同 token 预算。
反馈用于构造训练标签;推理时从观测预测 token 并解码,不需要专家动作。token 数控制细化深度,动作片段长度保持不变。
🧪实验验证:控制表现与 token 效率
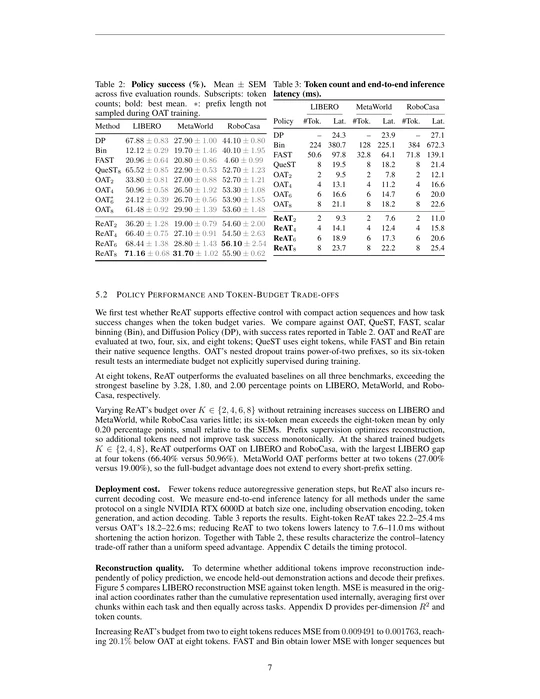
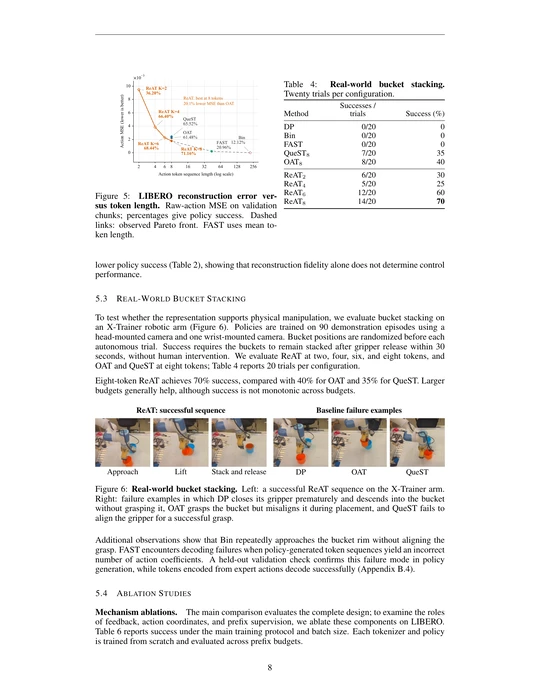
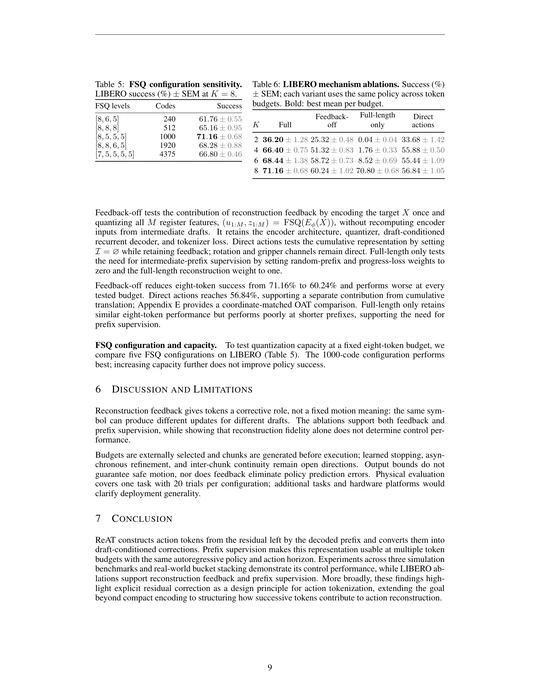
覆盖 LIBERO、MetaWorld、RoboCasa 的18个仿真任务及1个真机叠桶任务。8-token ReAT 在三个仿真基准的成功率为71.16%/31.70%/55.90%,均高于本实验所比较的基线。
在 LIBERO,4-token ReAT 达到66.40%,超过8-token QueST(65.52%)与OAT(61.48%)。真机叠桶中,8-token ReAT 为70%(14/20),OAT与QueST分别为40%/35%,各测试20次。
🚀总结:让每个 token 都有修正的目标
结果提示:显式残差反馈与前缀监督,有望让动作 token 从紧凑编码进一步成为逐步修正动作的表示,支持控制表现与推理开销的取舍。欢迎阅读论文、交流讨论!
#具身智能 #机器人操作 #机器人学习 #人工智能