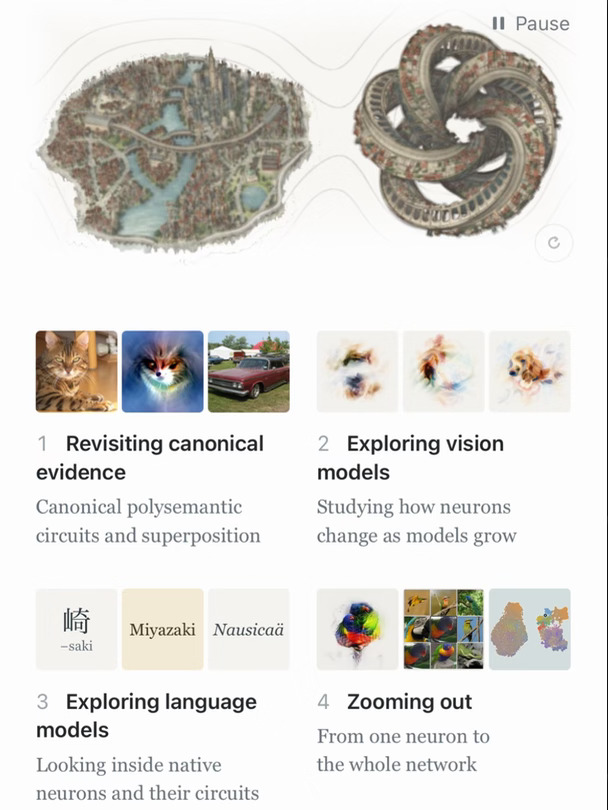
今天 AI 圈出了个大反转:整个学术界可能被一个“乌龙”骗了整整六年。前 OpenAI 可解释性元老、Goodfire 研究员 Nick Cammarata 刚发了一篇重磅调查,亲手推翻了自己当年写下的教科书级结论。
2019 年,学者们扒开早期视觉模型(InceptionV1),发现同一个神经元居然同时对“猫脸”和“汽车前脸”起反应;到了 2023 年,OpenAI 和 Anthropic 排查语言模型,发现能看懂的神经元不到 2%,可理解分中位数直接是 0 分。
全行业由此认定了悲观的“叠加态假说”:AI 为了省空间,会把毫无关联的概念硬塞进同一个神经元。从此大家不敢直接研究神经元,全在砸算力训练辅助工具,试图先解开这个“死结”。
结果六年过去,Nick 一路复查到最新的 Qwen3-32B 和万亿参数的 Kimi K3,发现真相让人哭笑不得:神经网络根本没打结,超 90% 的神经元其实都只专心干一件事!
当年所谓的“死结”,其实是三个乌龙:
1. 把架构 Bug 当成了规律
早期模型最后一层看不懂,纯粹是老架构缺陷导致深层溢出。修好基础缺陷后,哪怕不改模型大小,最后一层近 100% 的神经元瞬间变得清清楚楚。
2. 神经元会像树枝一样“顺藤摸瓜”
少数看似无厘头的跨界,其实是顺着逻辑长出了分支。比如一个神经元最初只认字母“iy”,后来顺势记住“diy”,最后竟延伸去识别完全不含 iy 的“do it yourself”。只看头尾以为它疯了,连起来看却无比丝滑。
3. 人类测试工具“眼神不好”
比如负责“泰坦尼克号”的神经元总在无关句子里乱闪,其实它是预测到下文即将出现“船(boat)”而提前激活,但只看上文的旧工具硬给它判了 0 分。
困扰学界六年的 AI 黑盒死结,原来只是人类当年拿错了放大镜。既然大模型内部本来就干净有序,我们终于不用再费劲给 AI 造“翻译机”,可以直接拿着手术刀在原生模型脑子里做实验了。
关注我 致力为每个人找到属于自己的AI战略工具
#大模型 #AI可解释性 #神经网络 #Qwen #Kimi #OpenAI #人工智能 #AI搞学习howto #howto实现一万种vibecoding #人工智障与人工智能