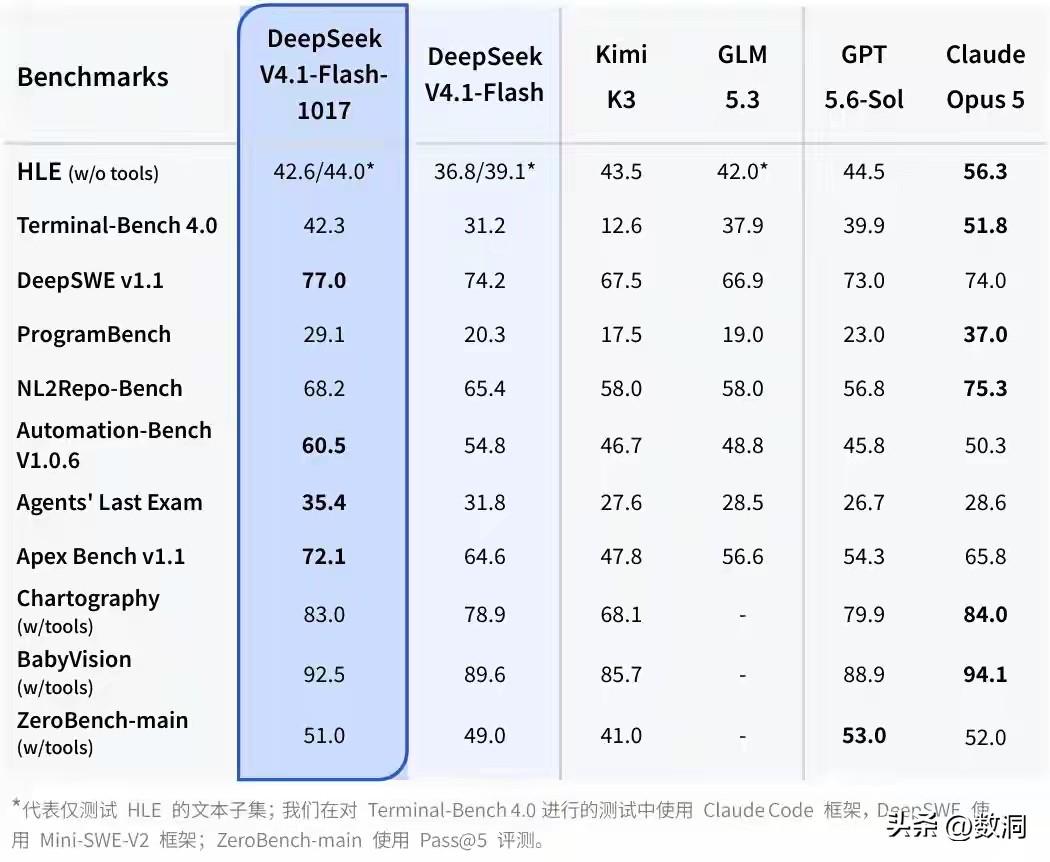
仅仅过了一个多月,DeepSeek同版本又完成了一次升级,这迭代速度非常惊人。
GPT靠堆算力输出长篇文本,token消耗很大。而最新版本的DeepSeek靠MoE混合专家架构和KV缓存压缩,使模型懂得精简输出,大大减少了无效文字。这样一来,同样完成写代码、方案整理,DeepSeek输出更简短精准。新版本V4.1 Flash,采用 MoE混合专家模型,每次提问只激活相关模块,而不是每次都把全部算力拉满,所以,token的用量直接减少。
AI不再靠堆参数变强,而是靠算法优化,减少无效文字输出,降低算力消耗。算力成本下降,最终受益人还是我们普通用户。
大模型赛道,已经从比拼参数大小,变成比拼算力效率。AI越聪明,我们付给AI的钱就会越少。