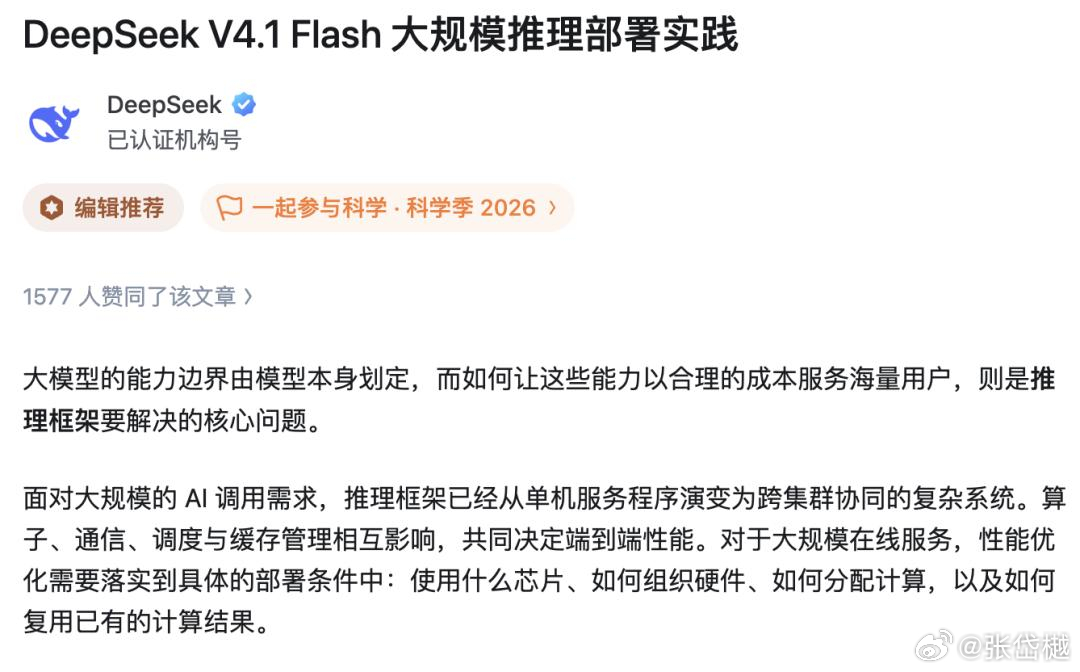
DeepSeek开源推理框架有何意义DeepSeek这次开源的,不是模型,是“怎么把模型跑得又便宜又快”的那套本事。
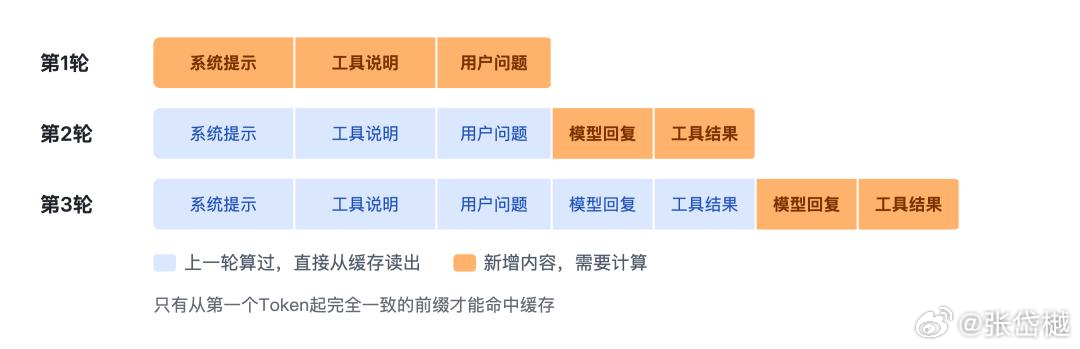
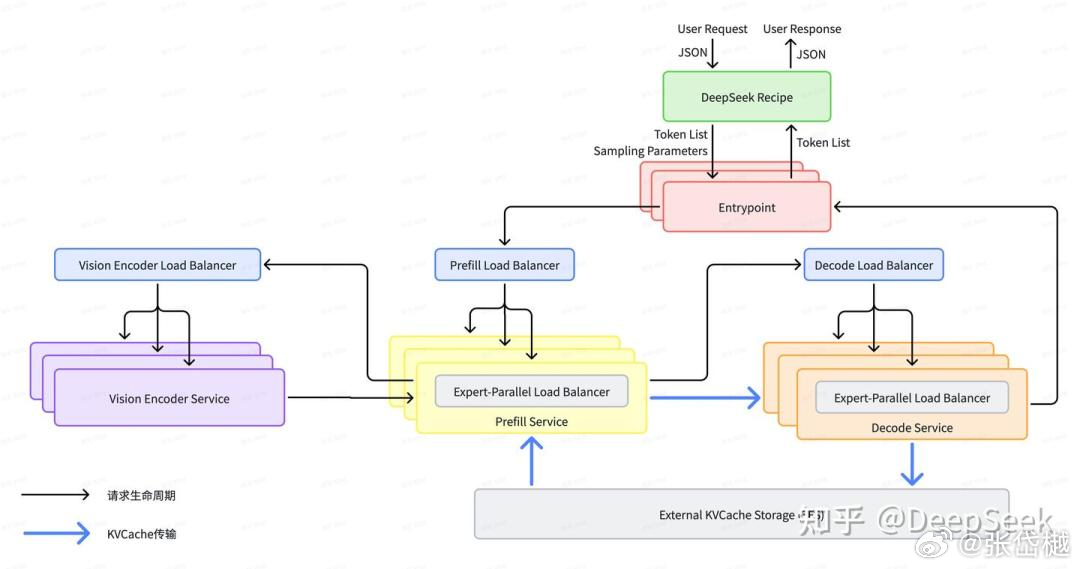
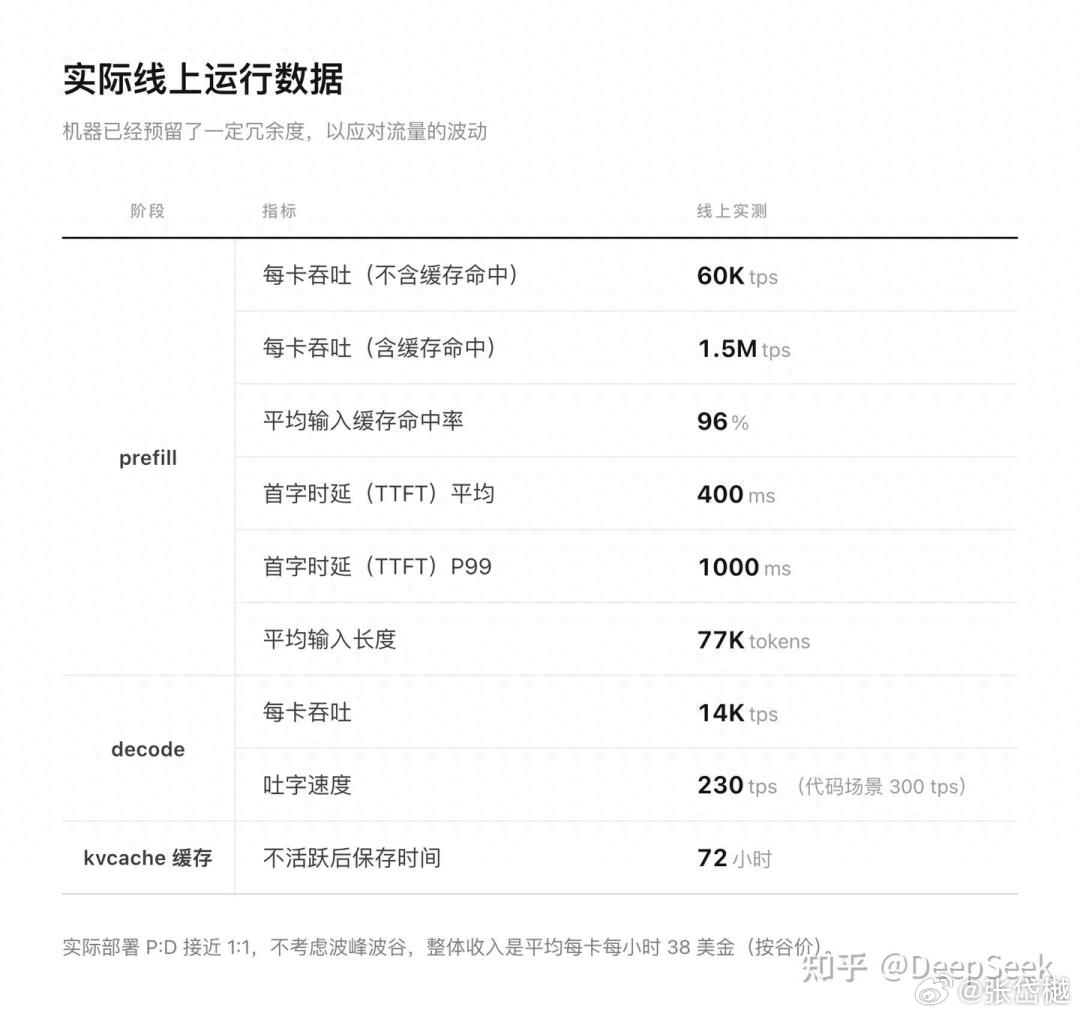
单集群日吞吐155万亿Token,平均首字延迟400毫秒,生成速度230 Token/秒,96%的输入直接命中缓存不用重算。这些数字背后是一整套调度、缓存和并行策略——以前藏在内部,现在全部摊开。
为什么愿意分享?官方说法是“降低算力成本、减少能源消耗,让智能以更低的价格触达更广泛的人群”。翻译一下:它不靠“只有我会省”来赚钱,而是把省钱的工程能力变成公共品,让整个行业的效率基线往上抬。
降价会不会来?短期看,当“怎么跑得便宜”不再是秘密,靠信息不对称维持的价格空间会被压缩。但真正的降价动力不在开源本身,在于DeepSeek证明了一件事:全栈效率做到极致,成本可以低到别人跟不动。开源是姿态,效率才是底牌。