现在看大模型,大家都习惯先盯跑分和榜单,其实模型能力到了这个阶段,真正决定能不能落地的,往往是水面下的算力账本。怎么调度芯片、怎么把成本打下来,才是各家暗中较劲的地方。
在这方面,DeepSeek最近交出了一份挺硬核的作业,他们公布了一份详细的技术报告,专门拆解了V4.1 Flash大规模推理系统是怎么部署的。重点没放在虚的模型能力上,他们直接把大规模云服务推理框架DeepInfer,以及生产级的组件deepseek-recipe进行了开源。
用大白话说,就是不仅自己把省钱算题的功夫练成了,还把核心的提效工具拿出来跟整个行业共享。
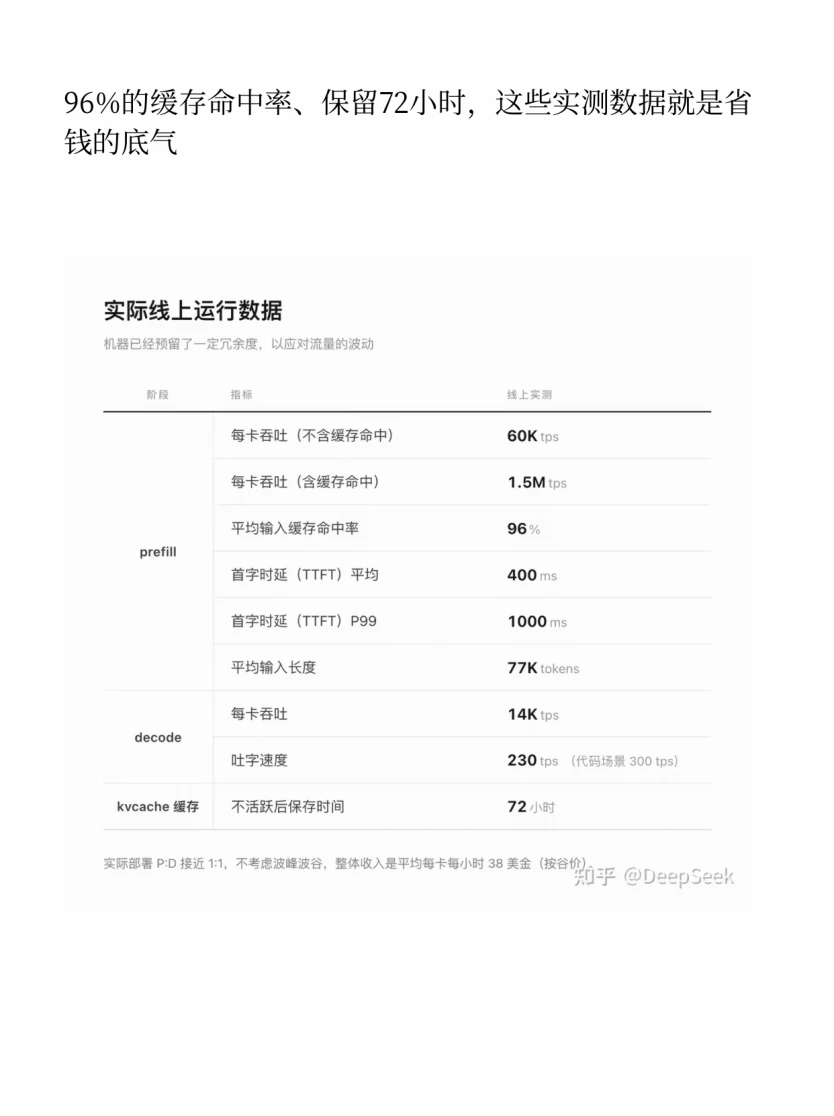
翻了翻报告里的细节,有几个省钱思路挺巧妙。比如,大家现在都在卷长文本,但上下文越长,算力成本就越高。他们搞了个优化,让KVCache能保留72小时以上,这就好比给服务器开了个超大号的缓存区,遇到相同前缀的请求,直接复用之前算好的中间状态,不用从头再算一遍。报告里提到,缓存能达到96%左右,算力就这么一点点抠出来了。
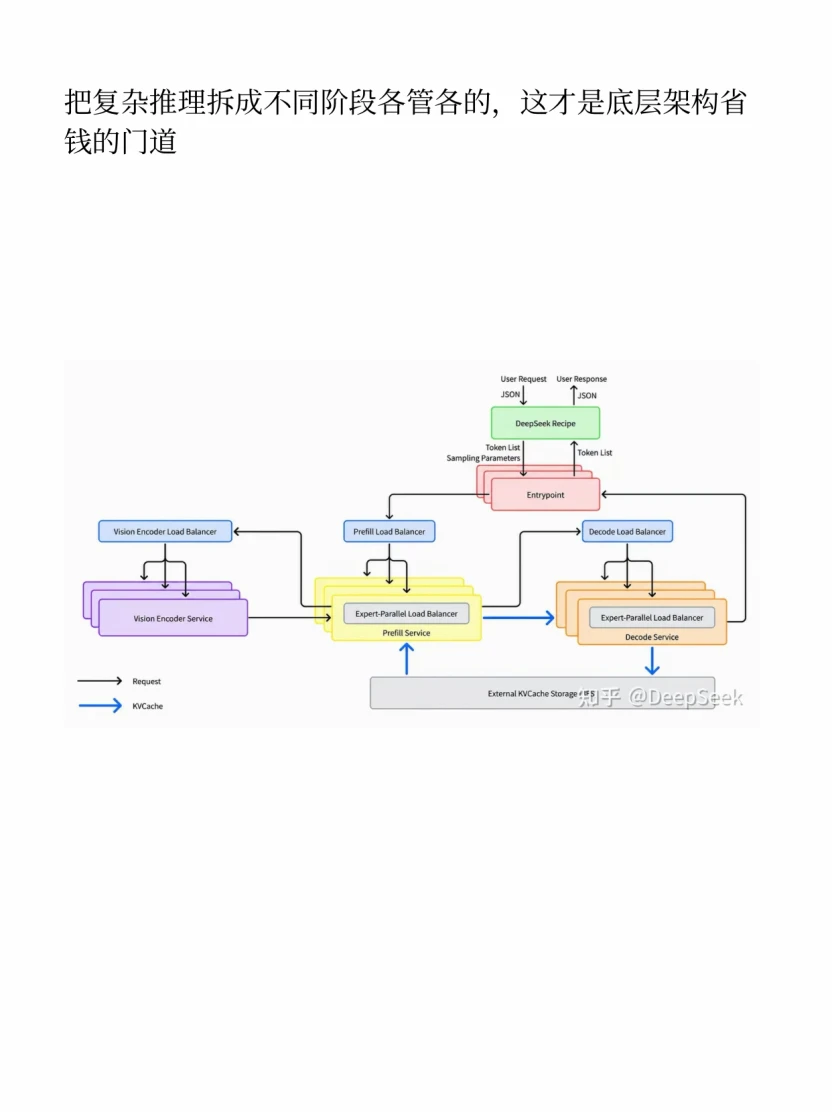
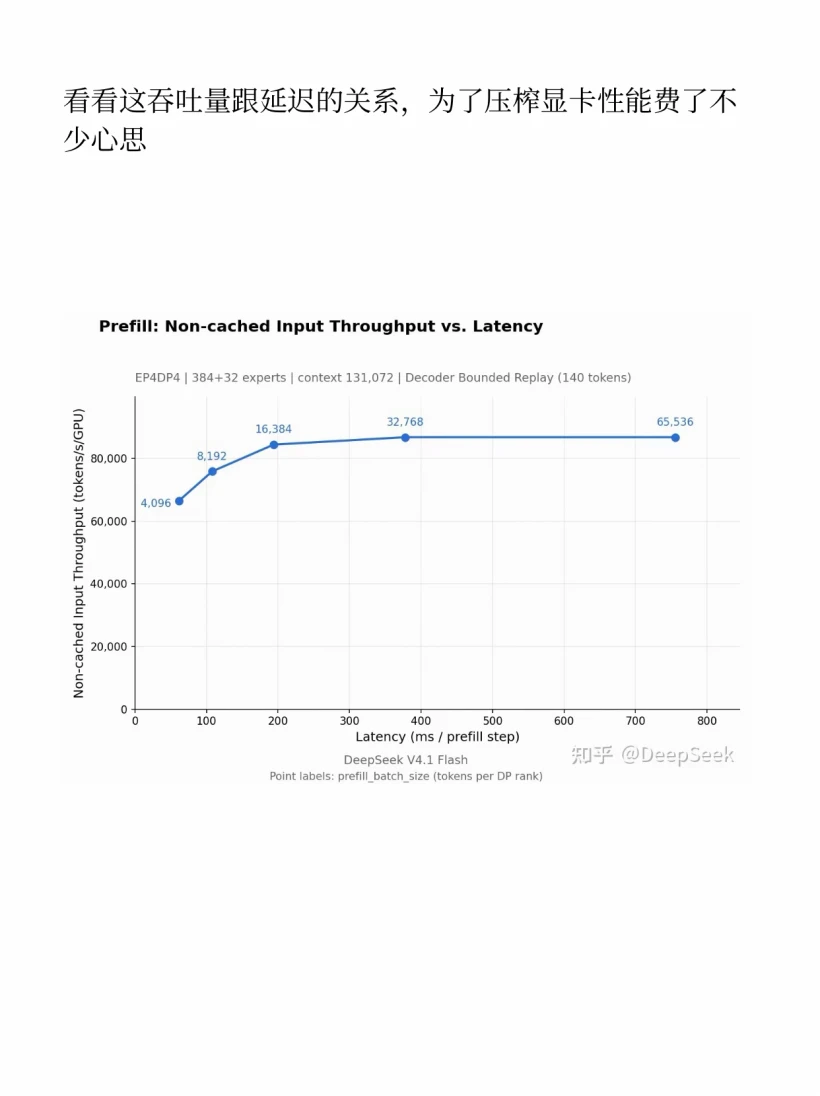
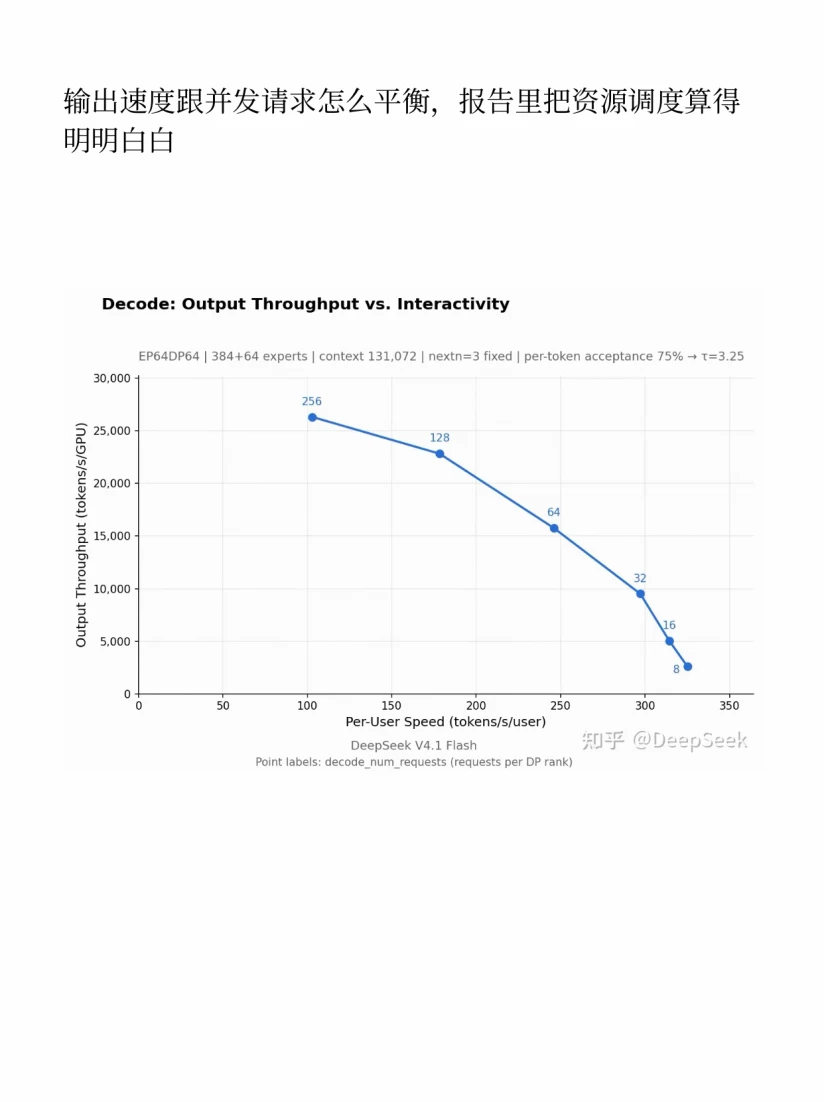
除了省缓存,架构调度上也算得很精,他们把推理过程拆成了不同阶段,各管各的,把不同任务分给不同配置的显卡集群去跑。最大化利用手里的算力,甚至面向多厂商的硬件也能兼容。
这种从底层抠出来的效率,效果相当直接,看数据就知道,现在他们单一集群的服务吞吐能达到每天155万亿Tokens。硬件效率上去了,服务侧的成本自然就跟着降,对开发者来说,这意味着同样一笔预算,能支撑更多的请求,大家用AI的门槛也就更低了。
话又说回来,这么硬核的技术拆解,其实挺挑读者的,这篇几万字的长文,发布阵地选在了知乎,并且这已经是他们第二次在这里发重磅技术文章了,上一次是揭秘Agent沙盒基础设施DSec,这次轮到了推理系统。
稍微琢磨下就懂,讲透这种底层的工程实践,光靠短视频或几页PPT根本说不清,得有人愿意耐下心来看架构图、抠数据。知乎上恰好聚着大批搞技术的开发者,这种硬核长文发出来,有很多人都在逐行抠细节,探讨得很专业。
对于真想看懂大模型底层逻辑的人来说,看这种原汁原味的干货,比看一些总结有价值得多。想扒一扒这套推理系统的技术底子,知乎看看这篇 tech report 就行,里面的工程细节确实多。
#DeepSeek #大模型 #AI基建 #技术报告 #知乎