美国AI专家:如果DeepSeek是一家美国公司,那么会出现疯狂的一幕!
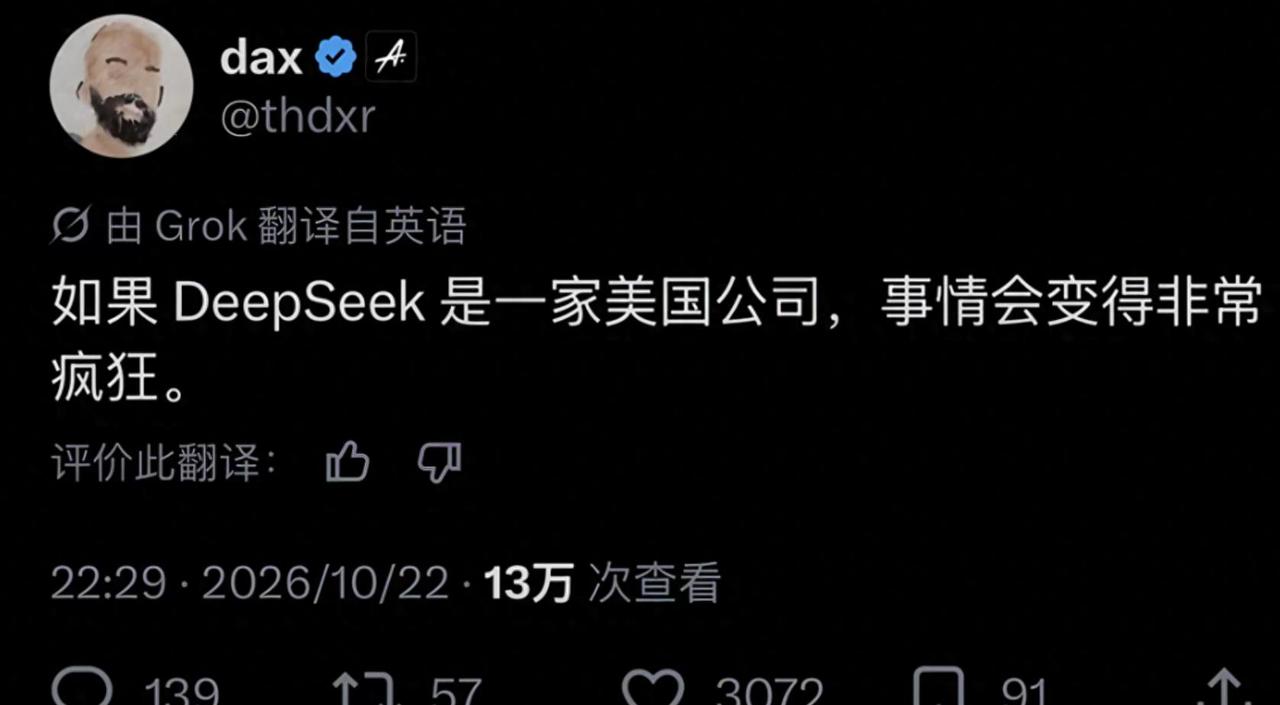
同一套模型、同样的开源和低价,换一面国旗,外界的讲法可能就完全不同。
AI编码工具OpenCode创始人Dax Raad抛出这个假设后,评论区很快补出了一个热闹版本:DeepSeek改名OpenSeek,关掉开源仓库,改成每月200美元的订阅服务,再登上各大杂志封面。
这当然是玩笑,却戳中了AI行业的现实:技术表现相近,企业所处的市场环境不同,得到的资本、舆论和政策待遇也可能天差地别。
在那个“美国版DeepSeek”的想象中,一家算力远不及对手的实验室,用MIT许可发布前沿模型,开放推理引擎和底层内核,每天处理155万亿个token,每GPU小时收入38美元。随后,资本蜂拥而至,150亿美元融资、天价挖人、巨头收购谈判接踵而来,创业者也会被当成科技英雄。
还有网友把这出戏演得更具体:创始人穿着抓绒衣上四小时播客,随手在餐巾纸上画张草图,就拿到900亿美元估值;几周后再把项目改成闭源付费服务,理由是“保护人类”。
调侃归调侃,背后说的是美国科技圈熟悉的剧本:一旦技术被认定有潜力,资本、媒体和大公司会迅速围上来,行业热度跟着冲高。
现实中的DeepSeek,走的却不是这条路,它更重视模型迭代和实际场景适配,围绕各行业需求打磨产品,没有被短期估值竞赛牵着走。资本追捧未必能换来技术进步,过热的融资和扩张也可能催生泡沫、打乱研发节奏。
2026年6月,美国企业费用管理平台Ramp的热门软件供应商榜单上,DeepSeek排到第一,这个榜单看的是企业首次采购了哪些供应商。
Ramp首席经济学家表示,美国公司正在寻找OpenAI和Anthropic的低价替代品,而且不少企业不是把模型下载到自家服务器里私下使用,而是直接购买DeepSeek的API服务。
旧金山AI初创公司Lindy就是一个例子,这家公司只有25人,原先使用Claude。创始人和财务核算开支时发现,API账单竟然比全体员工工资加起来还高,转用DeepSeek-V4后,推理成本降了约95%,一年能省下数百万美元。
对小公司来说,这不是抽象的技术路线之争,而是账上能不能撑到下一轮融资。DeepSeek V4 Flash每百万token收费0.18美元,Anthropic的Claude Opus 4.7则是25美元,价差约139倍。模型质量达到业务可用的程度后,价格就很难再被忽略,Lindy创始人的判断很直接:多数初创公司付不起品牌溢价。
这种压力并非个别企业的感受,近200家硅谷初创企业联名致信白宫,反对限制中国开源模型;英伟达、微软、Meta等25家科技公司也加入相关联署。
它们看重的是现实成本:中国开源模型在性能接近时,API价格能低六到九成,已经进入不少美国创业公司的技术栈。供给一旦被切断,最先承压的可能是小企业,受益的反倒是少数闭源巨头。
OpenRouter的数据也呈现出类似变化:中国AI模型的token使用占比,从2025年上半年的约4%升至46%。这说明企业不会只按口号选模型,价格、效果、稳定性和接入便利,都会进入实际决策。
当然,资本追逐也不是技术实力的唯一证明,美国市场擅长迅速聚集资金、人才和关注度,可能推动企业加速扩张;但热度太高,也会带来估值泡沫和资源错配。
DeepSeek更贴近本土行业需求、逐步打磨产品的路径,未必更耀眼,却能检验模型能否持续解决真实问题。看一家AI公司,不能只看它融了多少钱,也要看它能不能长期把事情做好。
今年10月中旬,DeepSeek推出V4.1-Flash-1017,跑分提升、任务耗时缩短,API价格没有上调。同一时期,美国国土安全部要求联邦机构全面移除DeepSeek产品及其衍生的第三方服务;DeepSeek则完成约1000亿元人民币融资,年内两轮累计约1500亿元,投前估值约5000亿元。
一边禁用,一边迭代,一边融资,几种力量挤在同一时间窗口里,争论早已不只是某个模型好不好用,而是围绕开源、成本、国家安全和市场竞争展开的较量。
Raad的假设之所以让人不舒服,是因为它逼人直面一个问题:如果代码和性能都没变,只是公司来自不同国家,评价标准为什么会变?说到底,AI赛道的竞争不只比谁能造出更强的模型,也比谁能让更多人用得起、用得上。
技术越普及,靠高价和封闭维持的优势就越难稳固。
信源:ZAKER(转载海外社交平台观点) 2026-10-26 09:06 美国 AI 专家抛出一个观点:如果 DeepSeek 是一家来自于美国的公司,那么接下来的事情会变得非常 “疯狂”