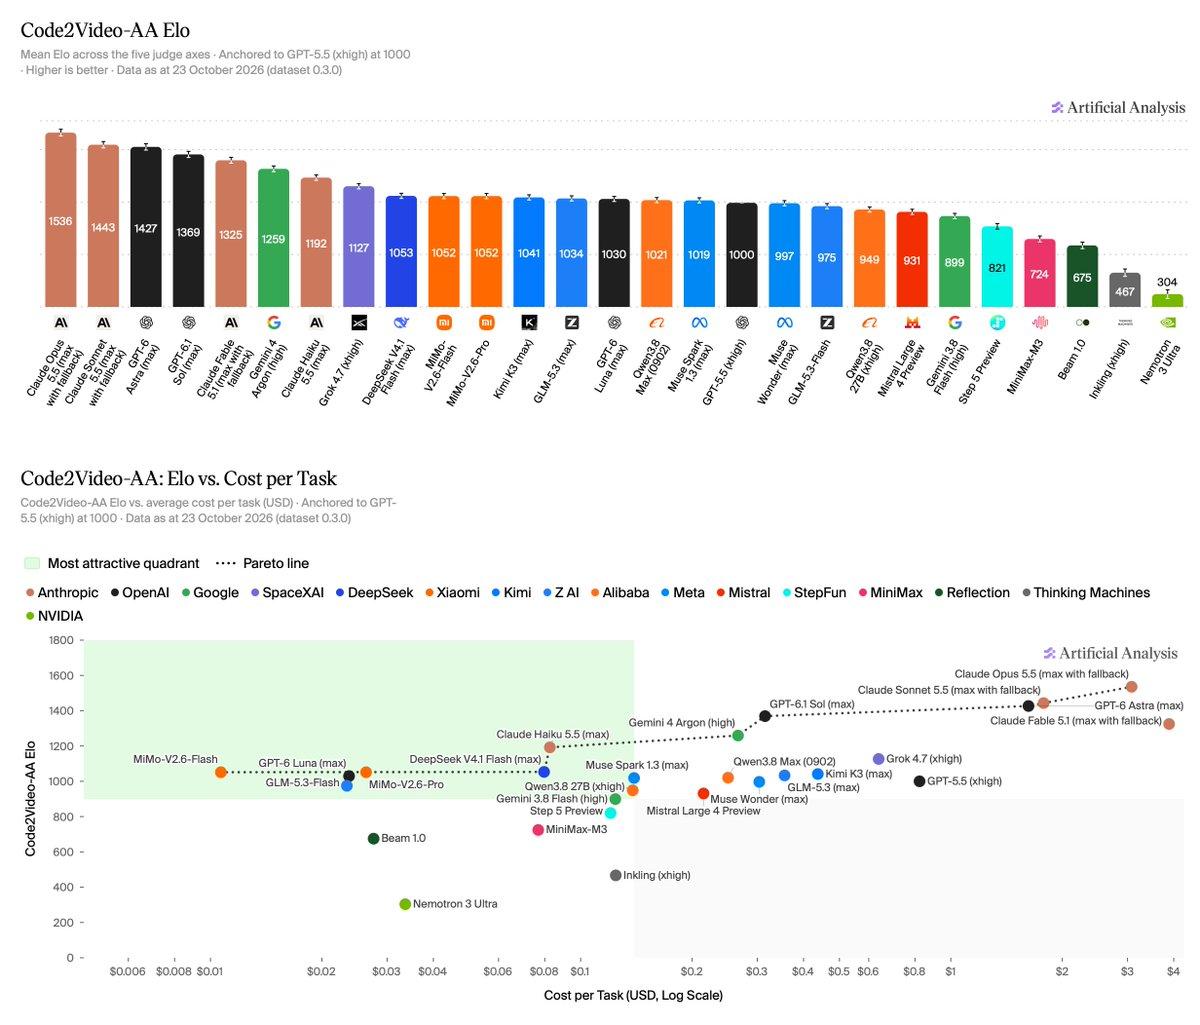
Artificial Analysis 发布独立基准 Code2Video-AA,基于 HeyGen 的 Code2Video Bench,让模型将 114 条产品/品牌营销简报写成 HyperFrames HTML 构图并渲染成视频。最终以五轴两两对比得出 Elo 总分:Claude Opus 5.5(max with fallback)以 1536 分领跑,单任务成本 3.08 美元;GPT-6.1 Sol(max)排第四,1369 分、仅 0.31 美元。
真正拉开差距的不是绝对分数,而是性价比曲线。成本跨度超过 300 倍,从 0.01 美元到 3.89 美元。Claude Opus 5.5 在 Engagement、Prompt Intent、Composition、Temporal Consistency、Craft 五个维度全面第一,但单价约是 GPT-6.1 Sol 的十倍;八个模型落在 Elo-成本帕累托前沿上,从 MiMo-V2.6-Flash(1052 分、0.01 美元)一直延伸到领跑者。开源权重模型整体落后至少 483 分,DeepSeek V4.1 Flash 以 1053 分位列开源第一。评测本身也严格:单次响应、无工具、无网络,失败渲染直接全负;裁判模型 Gemini 4 Argon 以 8 帧/秒抽帧做超过 3.5 万次两两裁决,最终 Elo 锚定在 GPT-5.5(xhigh)的 1000 分。
这条基准把“会写代码”和“能产出可用营销视频”之间的鸿沟量化了。高分闭源模型仍明显领先,但成本差一个数量级,意味着规模化部署时多数团队会主动选择次优却更便宜的方案——代码生成视频的真正瓶颈,已经从“能不能做”转向“值不值得用最贵的那个”。