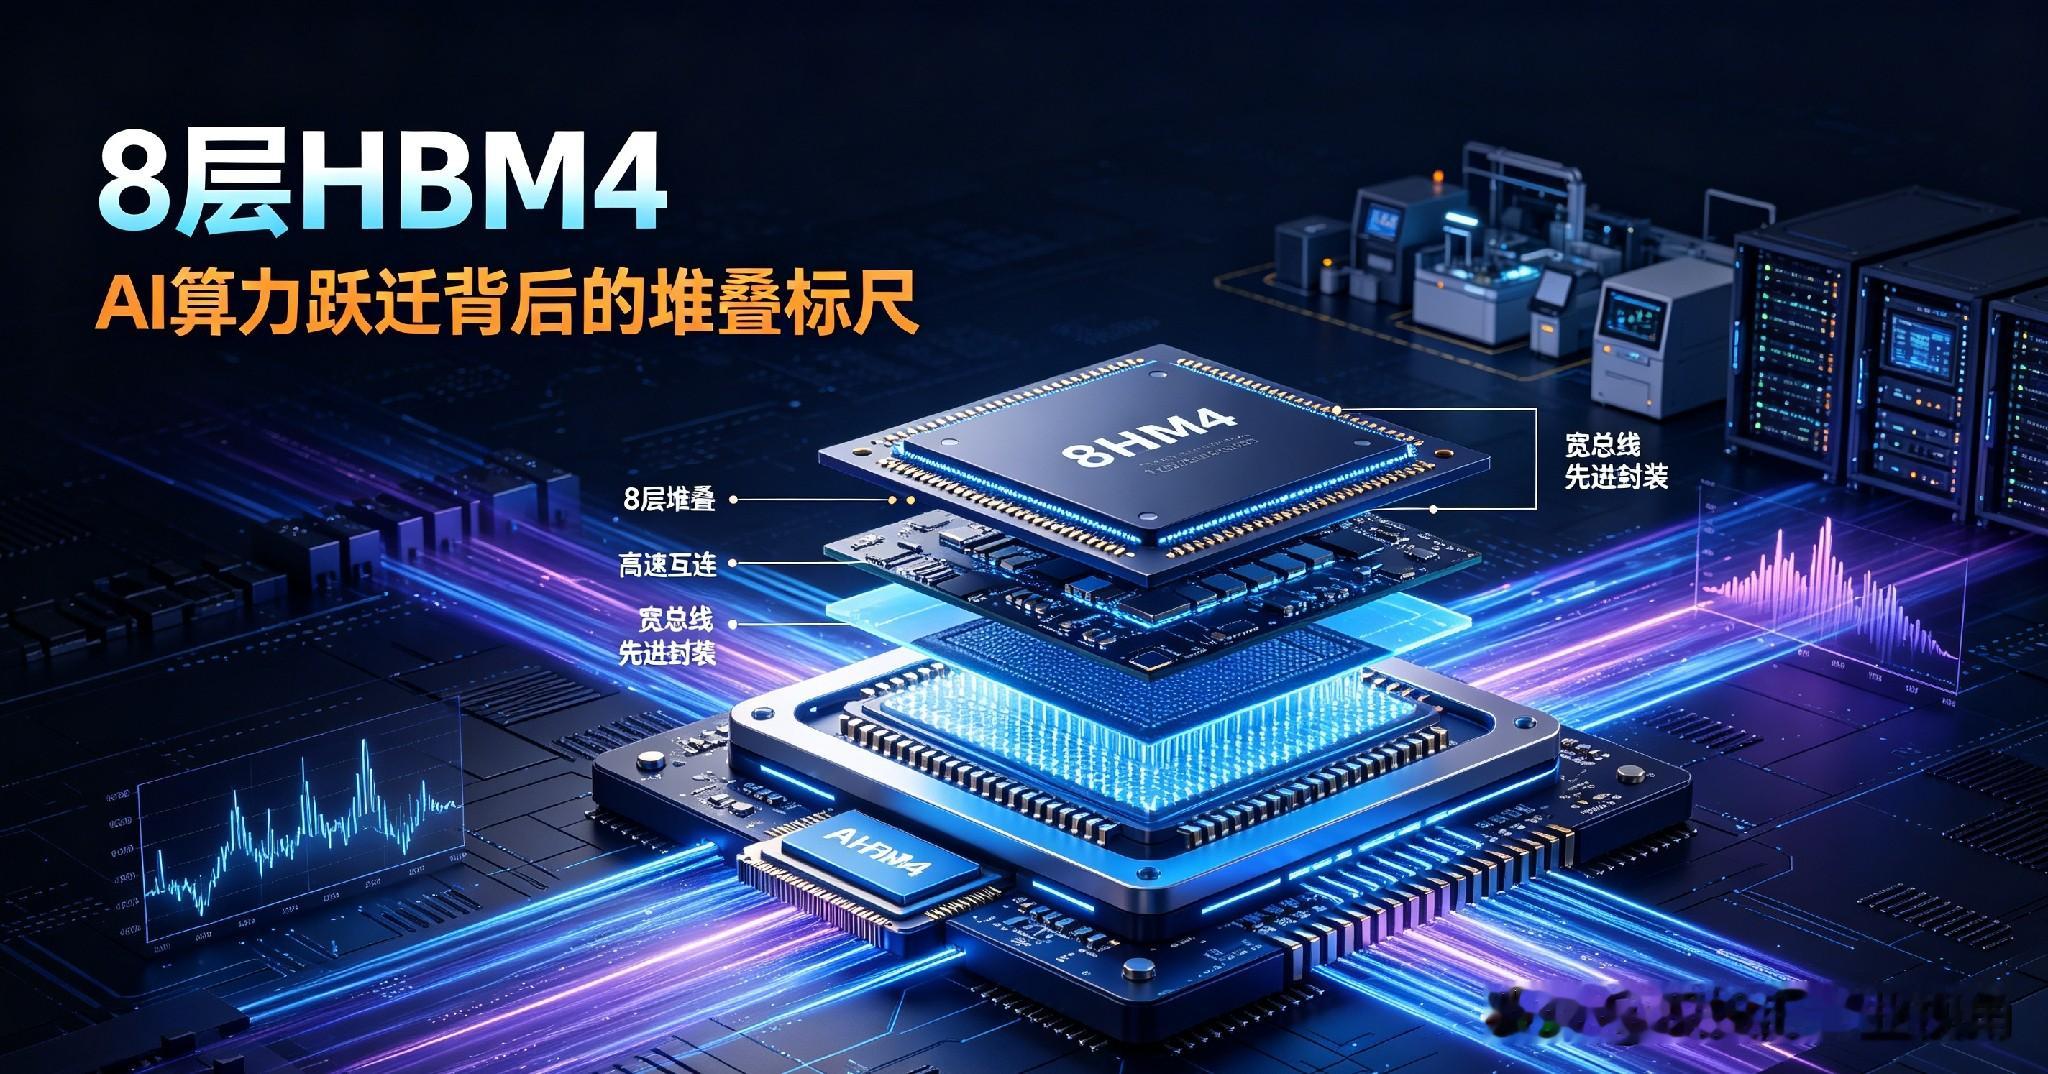
标题:8层HBM4,AI存储新一轮的算力带宽支点
大模型持续推高算力对带宽的需求,HBM4是新一代高带宽存储器,8层版本属于HBM4里面基础主力规格,兼顾成本、功耗与量产难度,是当下算力服务器优先落地的型号。
一、赛道定位
HBM是堆叠式高带宽显存,放在GPU旁边,解决算力芯片“吃不饱数据”的存储墙问题。
- 8层HBM4:主流起步规格,单颗容量、带宽相比HBM3E明显上一个台阶,良率可控,适合大规模服务器集群放量;
- 更高规格12层/16层HBM4:带宽更大,但堆叠工艺难度、热管理、良率压力陡增,现阶段偏向高端定制、少量供给;
赛道需求主要分两块:通用大算力训练推理集群、高端AI加速卡、超算。
二、核心技术壁垒
1、晶圆键合堆叠工艺
8层Die垂直堆叠,微凸点键合,上千个信号通道要同步连通,层间对准精度要求极高,微小偏移就直接报废,堆叠良率是第一道大关。
2、热管理壁垒
多层芯片挤在狭小空间,高密度发热集中。HBM4相比前代速率提升,单位功耗密度更高,层间散热设计、材料选型直接决定长期稳定运行。
3、测试与信号完整性
高速并行信号传输,极易出现串扰、信号衰减。8层堆叠之后信号链路更长,高速测试方案、探针卡、时序校准门槛大幅抬升。
4、配套生态
和AI芯片的IP适配、控制器、内存接口标准协同,需要和GPU厂商联合调试,认证周期漫长。
三、国内外核心厂商格局
海外
- 三星:HBM迭代节奏领先,8层HBM4率先送样、导入头部算力客户,产能布局靠前;
- SK海力士:HBM核心玩家,HBM4 8层方案同步推进,客户覆盖多家海外AI芯片厂商;
- 美光:跟进HBM4路线,侧重功耗优化,稳步推进8层规格验证。
国内
国内还没有成熟HBM4产品落地,当前攻关集中在HBM3、HBM3E技术路线:
- 长鑫存储:主攻HBM研发,布局堆叠、键合、配套测试工艺;
- 江波龙、佰维存储:偏向HBM封装配套、模组方案;
- 通富微电、长电科技:先进封装,具备2.5D/3D堆叠封装研发能力,是国产HBM落地的封装底座。
四、产业判断
8层HBM4是短期放量主力,兼顾量产可行性与性价比,会成为这一轮AI算力扩容的标配存储。
12层以上高堆叠版本属于远期高端路线,短期受良率和成本约束很难大规模铺开。
海外三巨头牢牢把持HBM4芯片供给;
国内差距主要在DRAM裸片本身,先进堆叠封装是追赶方向,整体处于研发验证阶段,距离商业化供货还有很长周期。
硬科技 HBM4 高带宽内存 AI算力 存储芯片
深投汇产业视角
免责:仅产业视角探讨,不含投资建议
互动评论:
GPU是算力核心,HBM负责输送数据,8层HBM4不是极限规格,却是最适合规模化上量的主力版本。