我在3个月内写了27万行代码近3000次提交,全年AI工具订阅花掉1.7万,遇到过太多吹上天却连小bug都改崩的模型。但这周测完Kimi K3.1 Pro,我的判断是,它已经是目前能正面叫板Claude的国产最强编程模型。
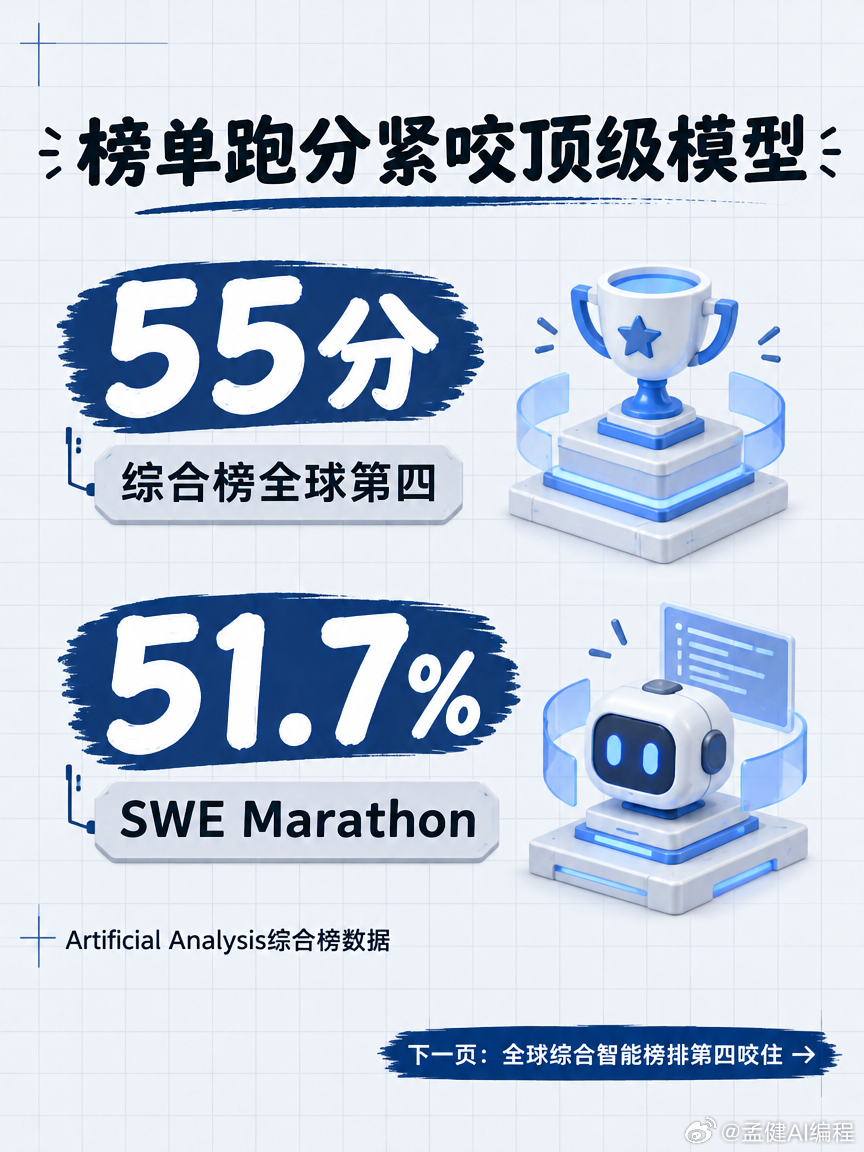
在第三方评测机构Artificial Analysis综合智能榜上,K3.1 Pro拿下55分排全球第四,比上一代K3直接涨了11分,拉开主流国产模型整整10分。在考验真实终端任务的Terminal-Bench 4.0上,它拿到65.7%,紧咬Claude Opus 5.5的66.4%;在SWE Marathon长程基准更以51.7%拿下第一。
但跑分再好看,不如拿真代码库算账。
我做内容分发工具字流时,有个卡了很久的陈年bug,发X长文章配图总会少1张(11张只插进10张),末尾还会残留乱码占位符。之前换过好几个模型,不是盲目改DOM就是越改越乱。
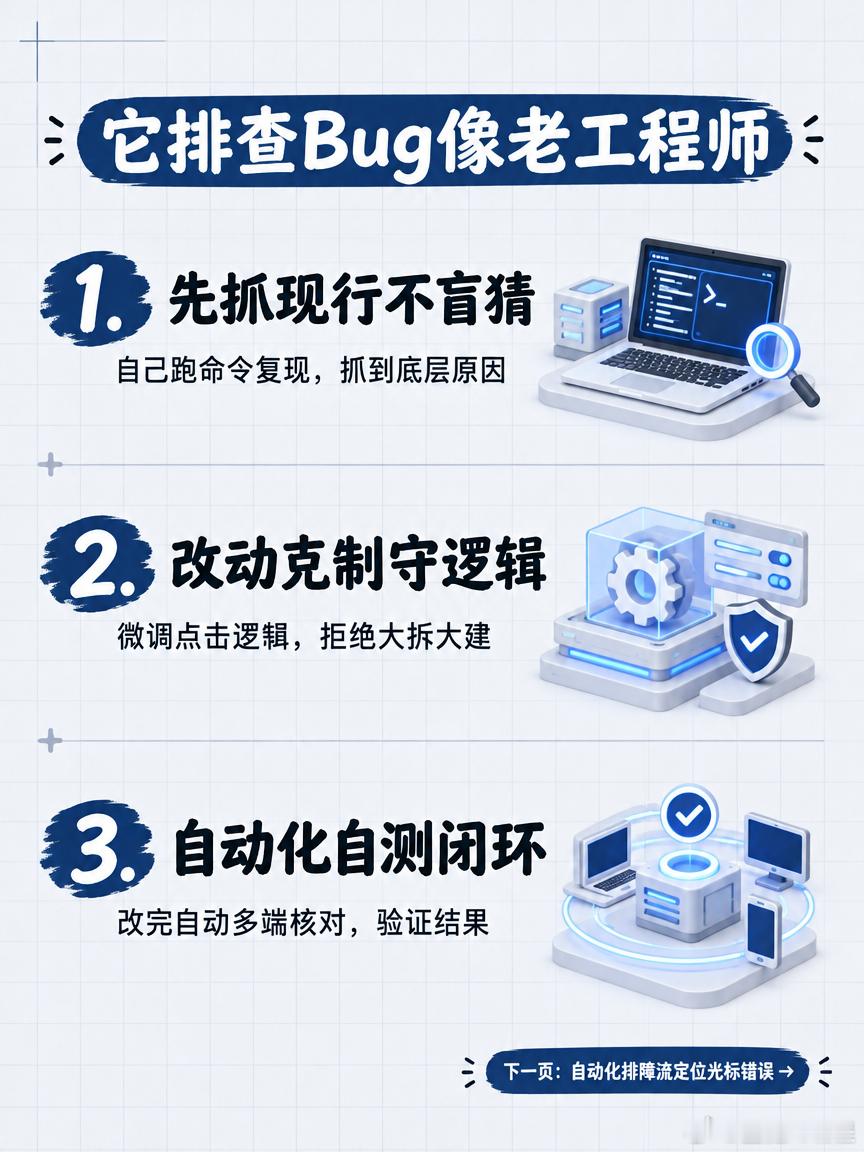
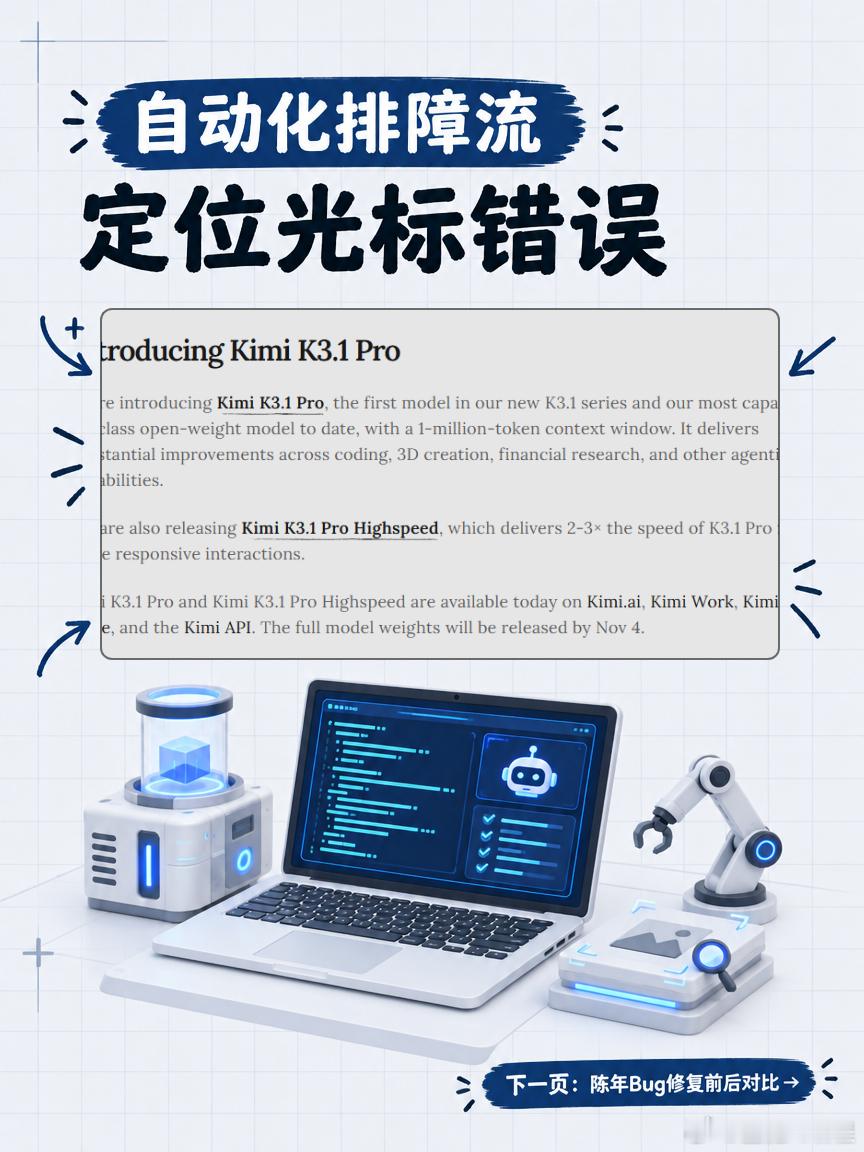
这次我把代码库丢给K3.1 Pro。它没有上来就胡乱提PR,而是先在终端跑复现命令,精准抓出是光标定位偏移导致图片漏插;接着把逻辑改成模拟鼠标点击占位符并保留校验,最后调起无头浏览器自测跑通。
从敲下回车到排查、重构、验证闭环,用时9分钟,我一行代码没写,测试结果,正文图片11/11张,残留占位0个。
很多AI遇到bug是先猜后改,而K3.1 Pro是标准的成熟工程师动作,先复现、抓现行、再精准修改并自测。
虽然长难任务稳定性比起Opus 5.5仍有距离,且大模型调用消耗额度不小,但官方承诺11月4日前开源完整权重。对于极度关注真实交付的独立开发者,这一代已经具备极高的实操价值。大家平时用AI编程搞定过最棘手的bug是什么?AI编程Kimi
完整清单:微信搜公众号「孟健AI编程」,回复「编程实测」自动发你。