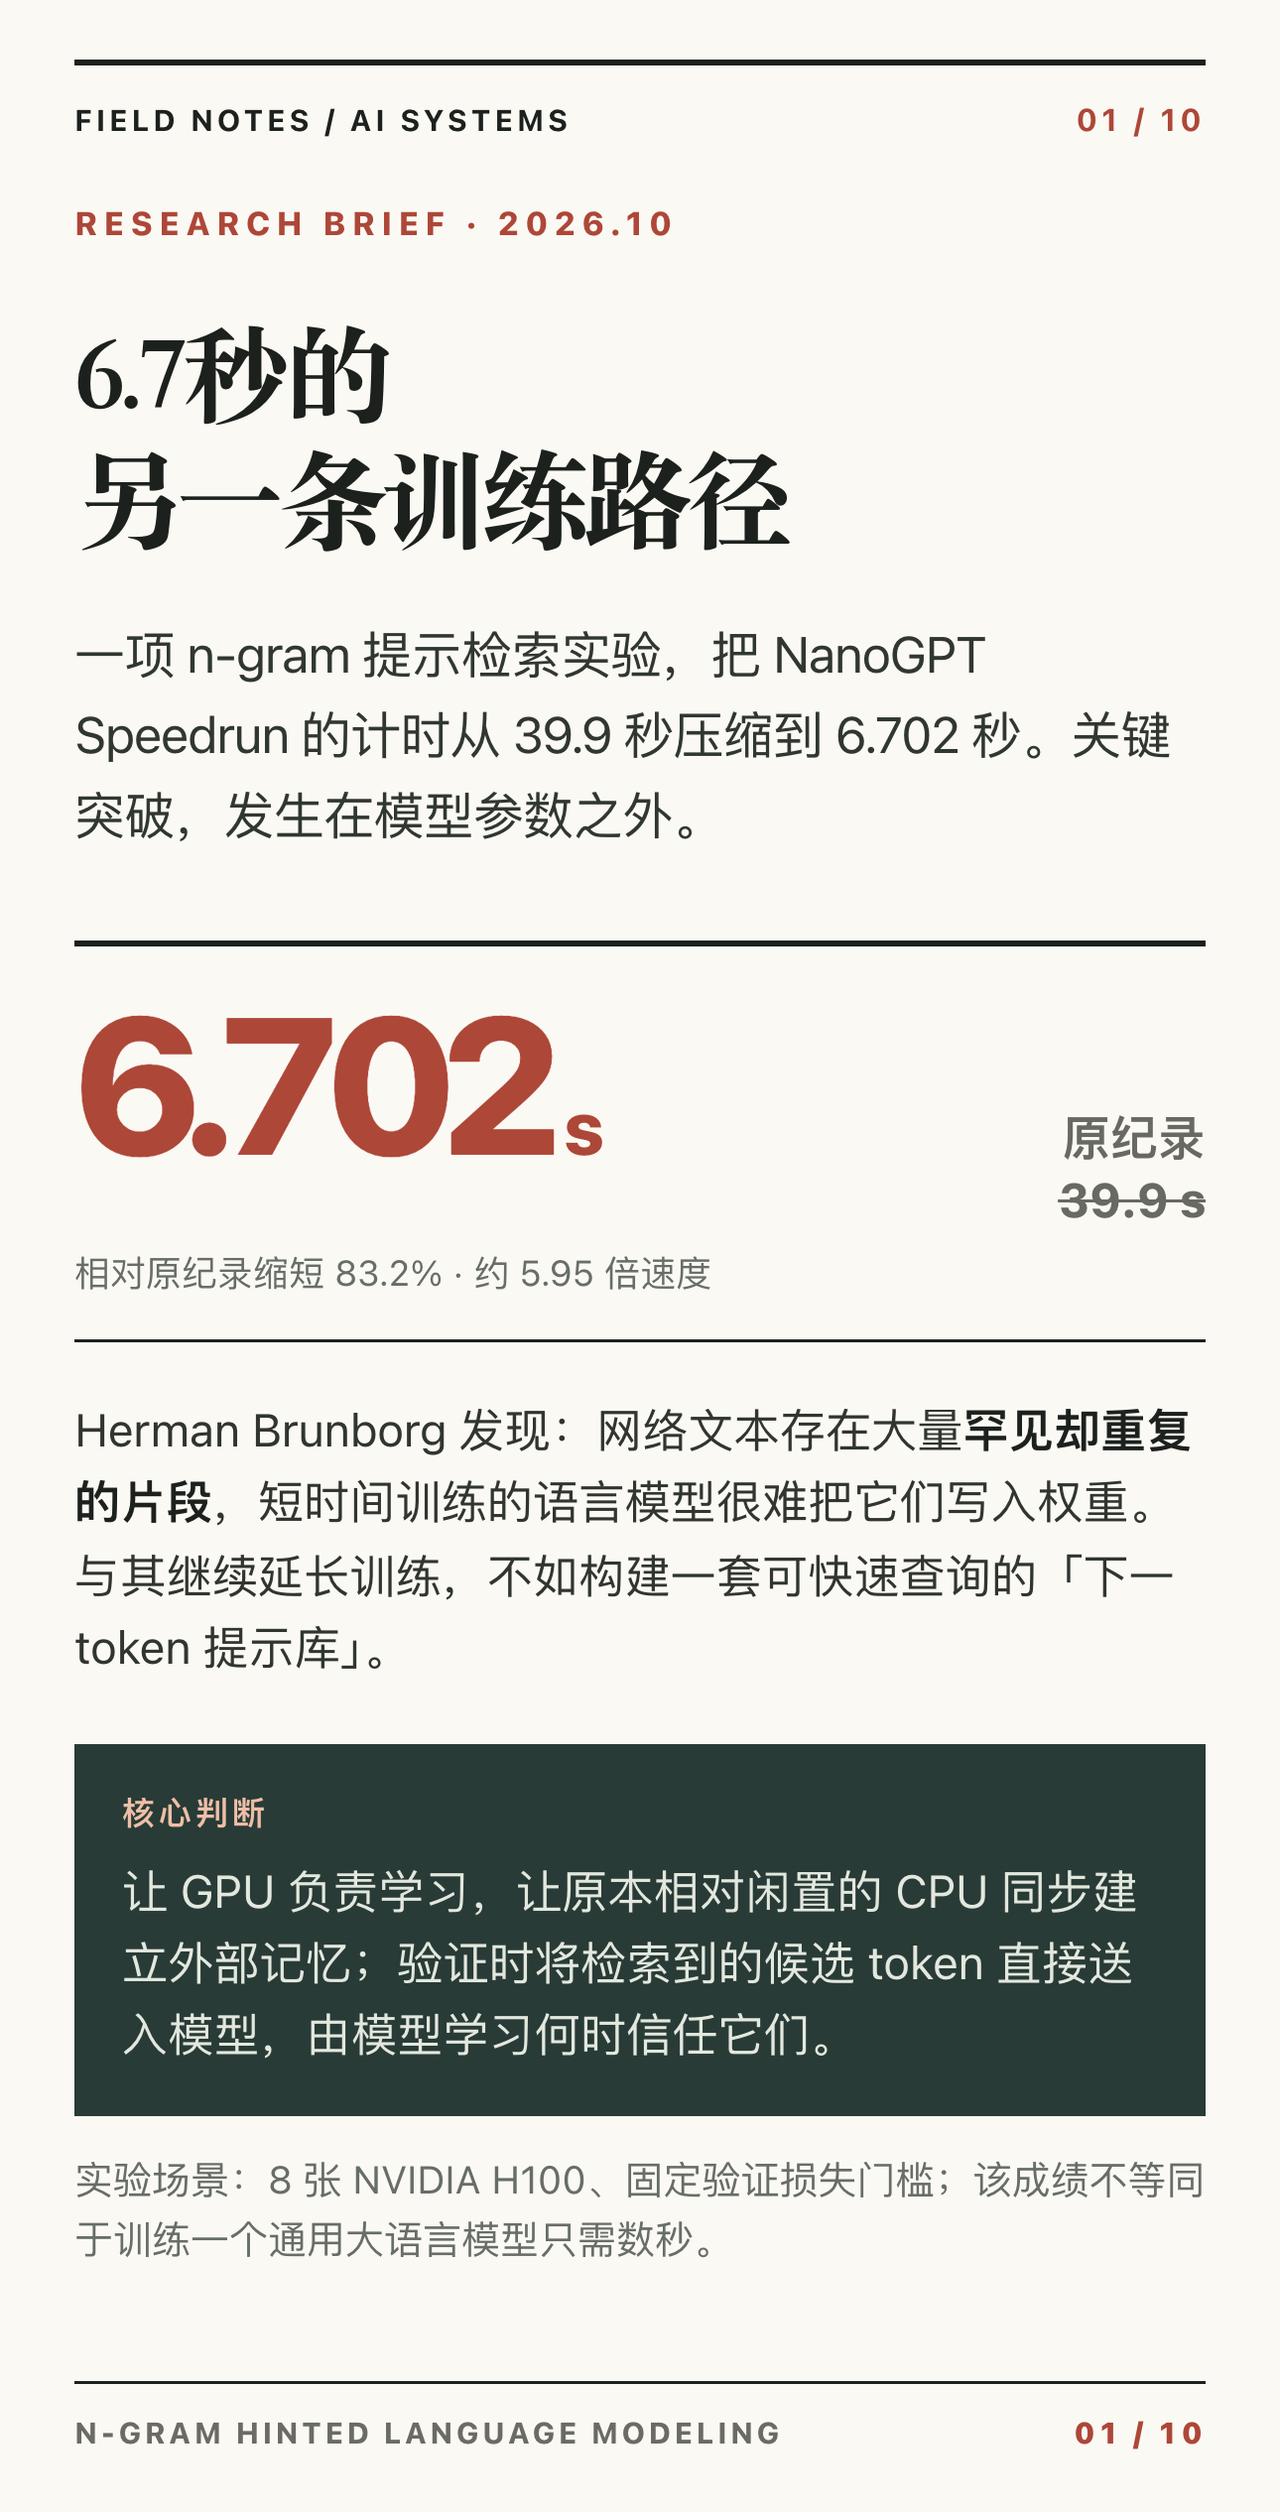
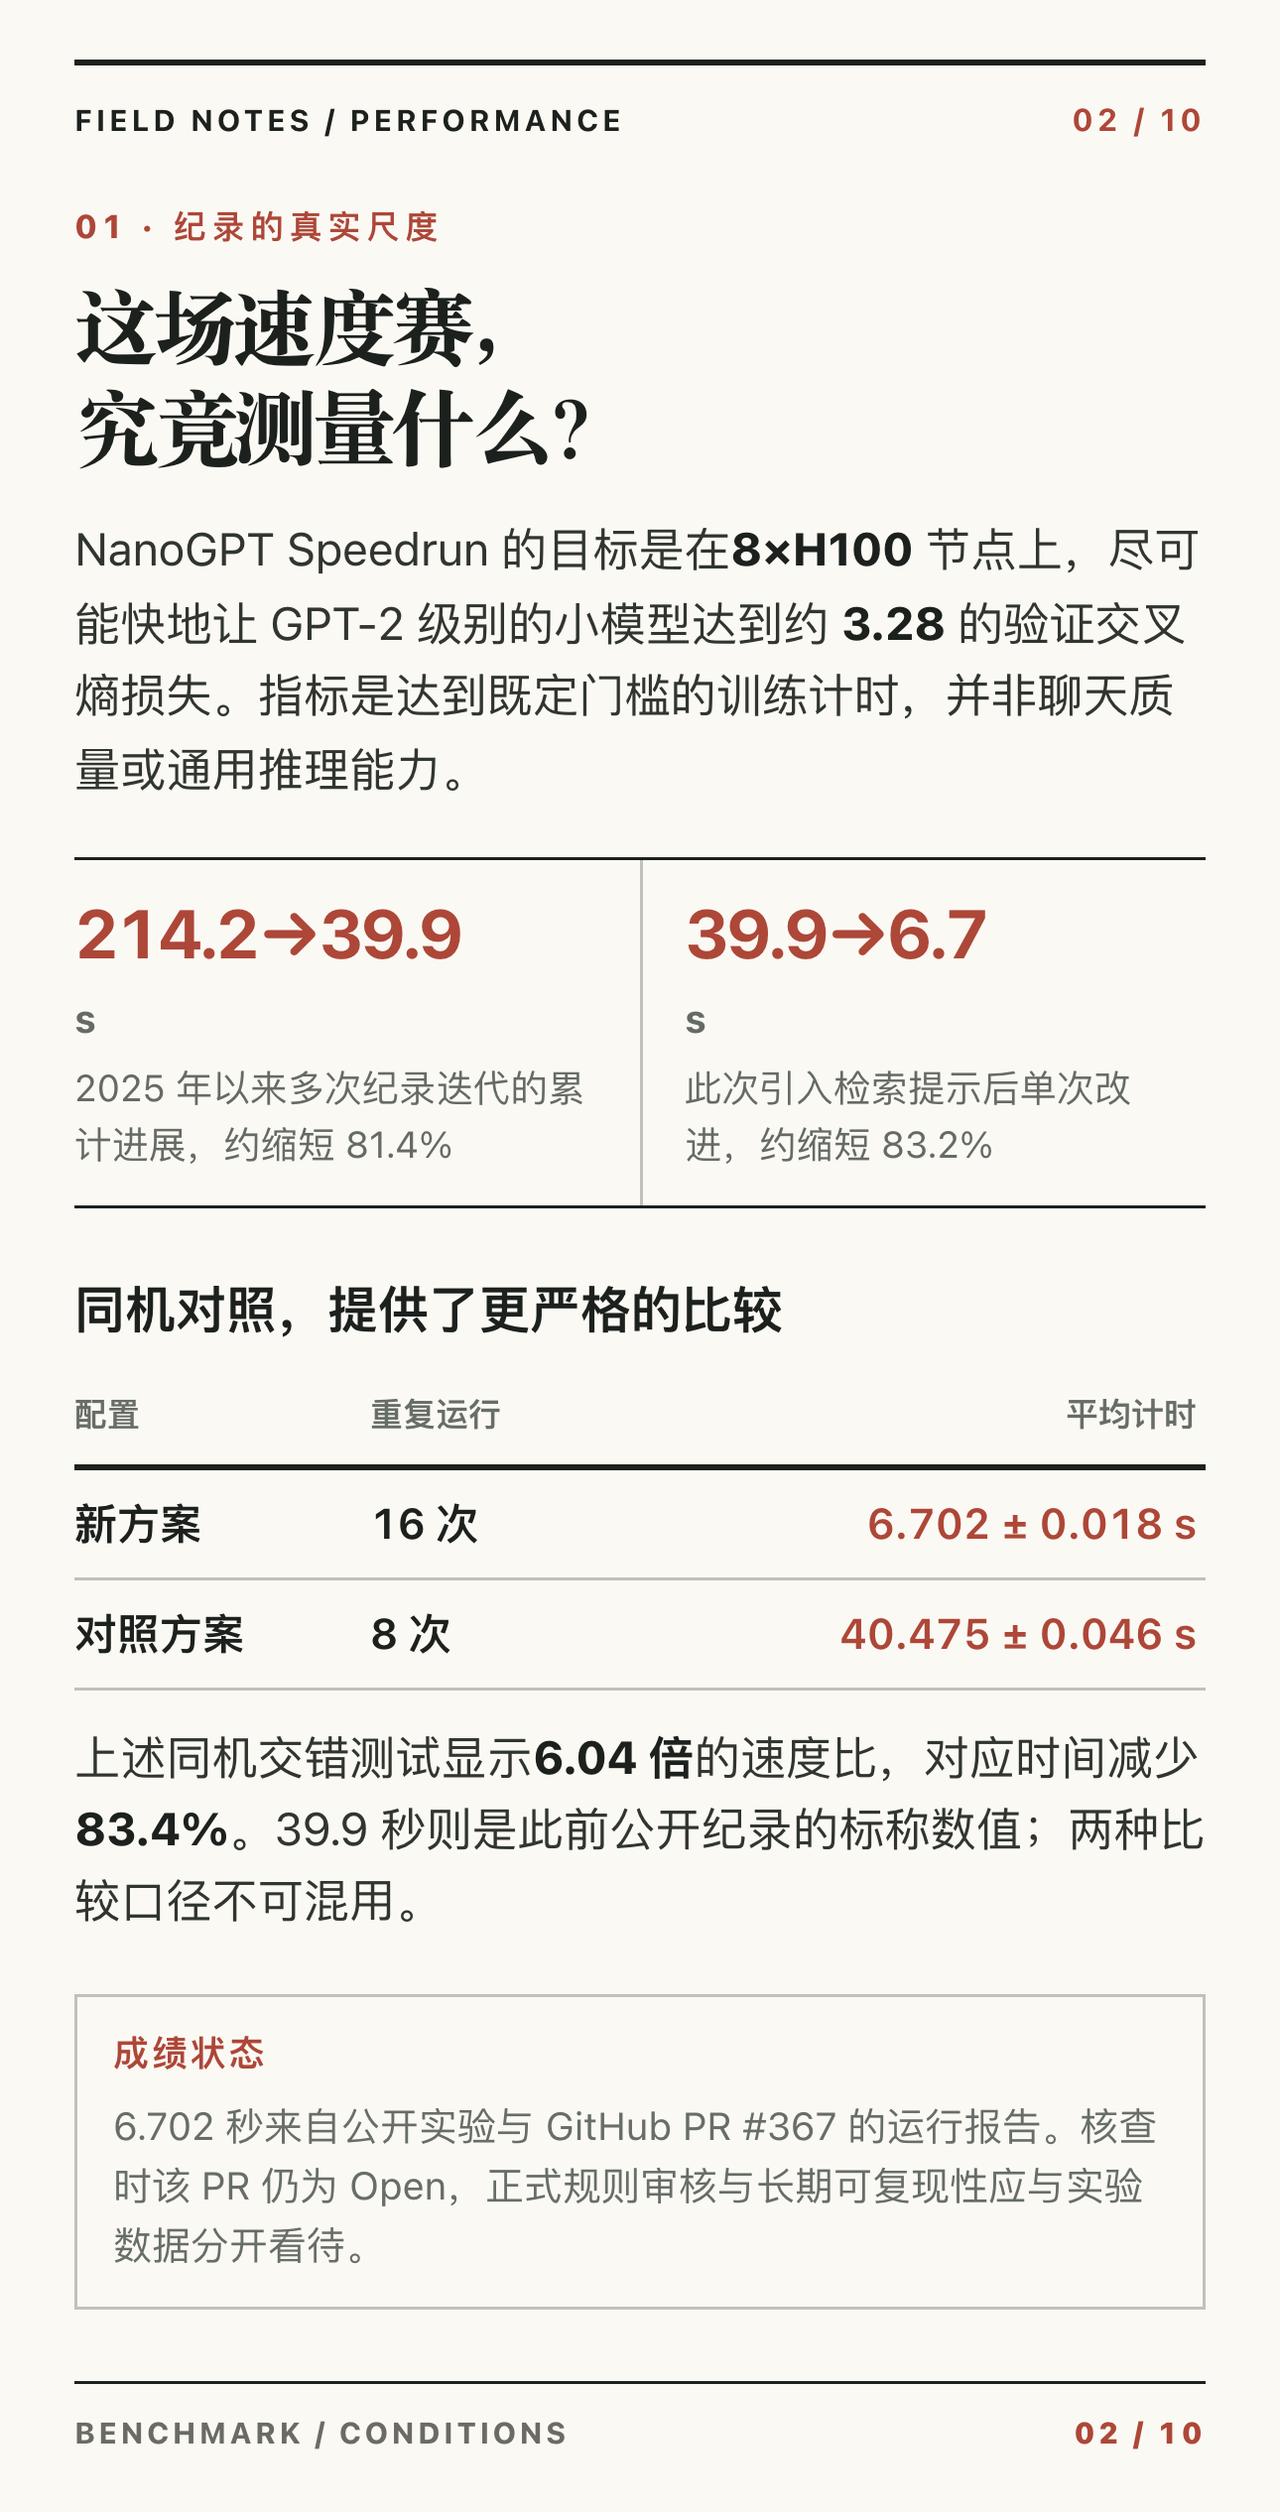
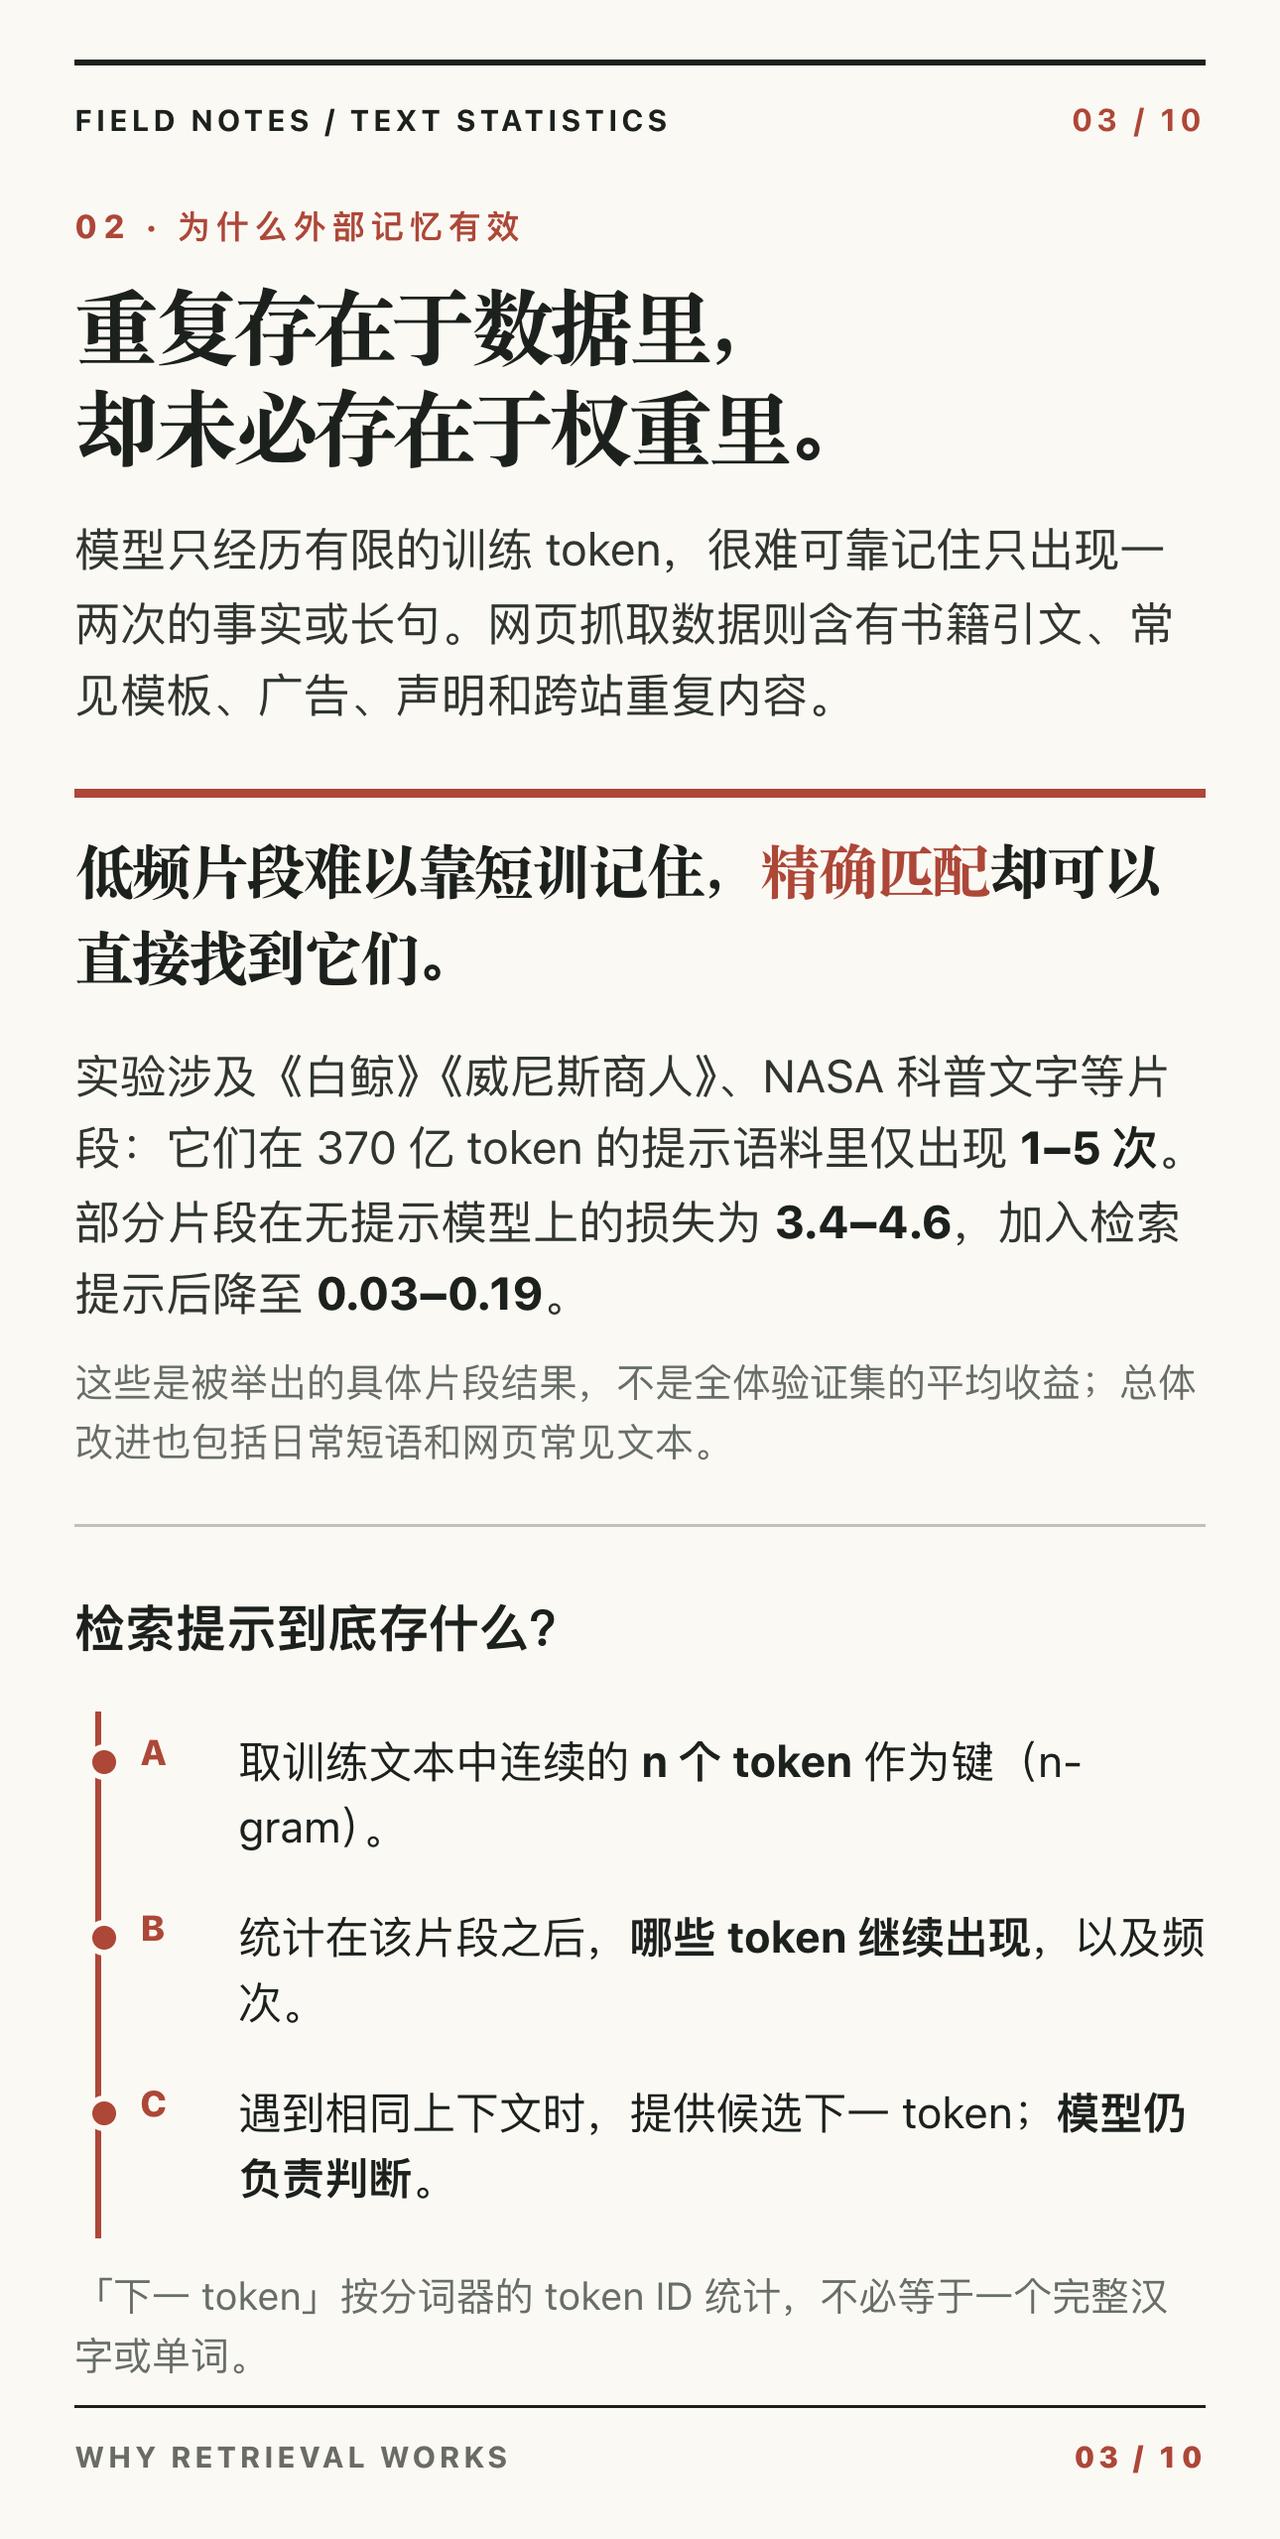
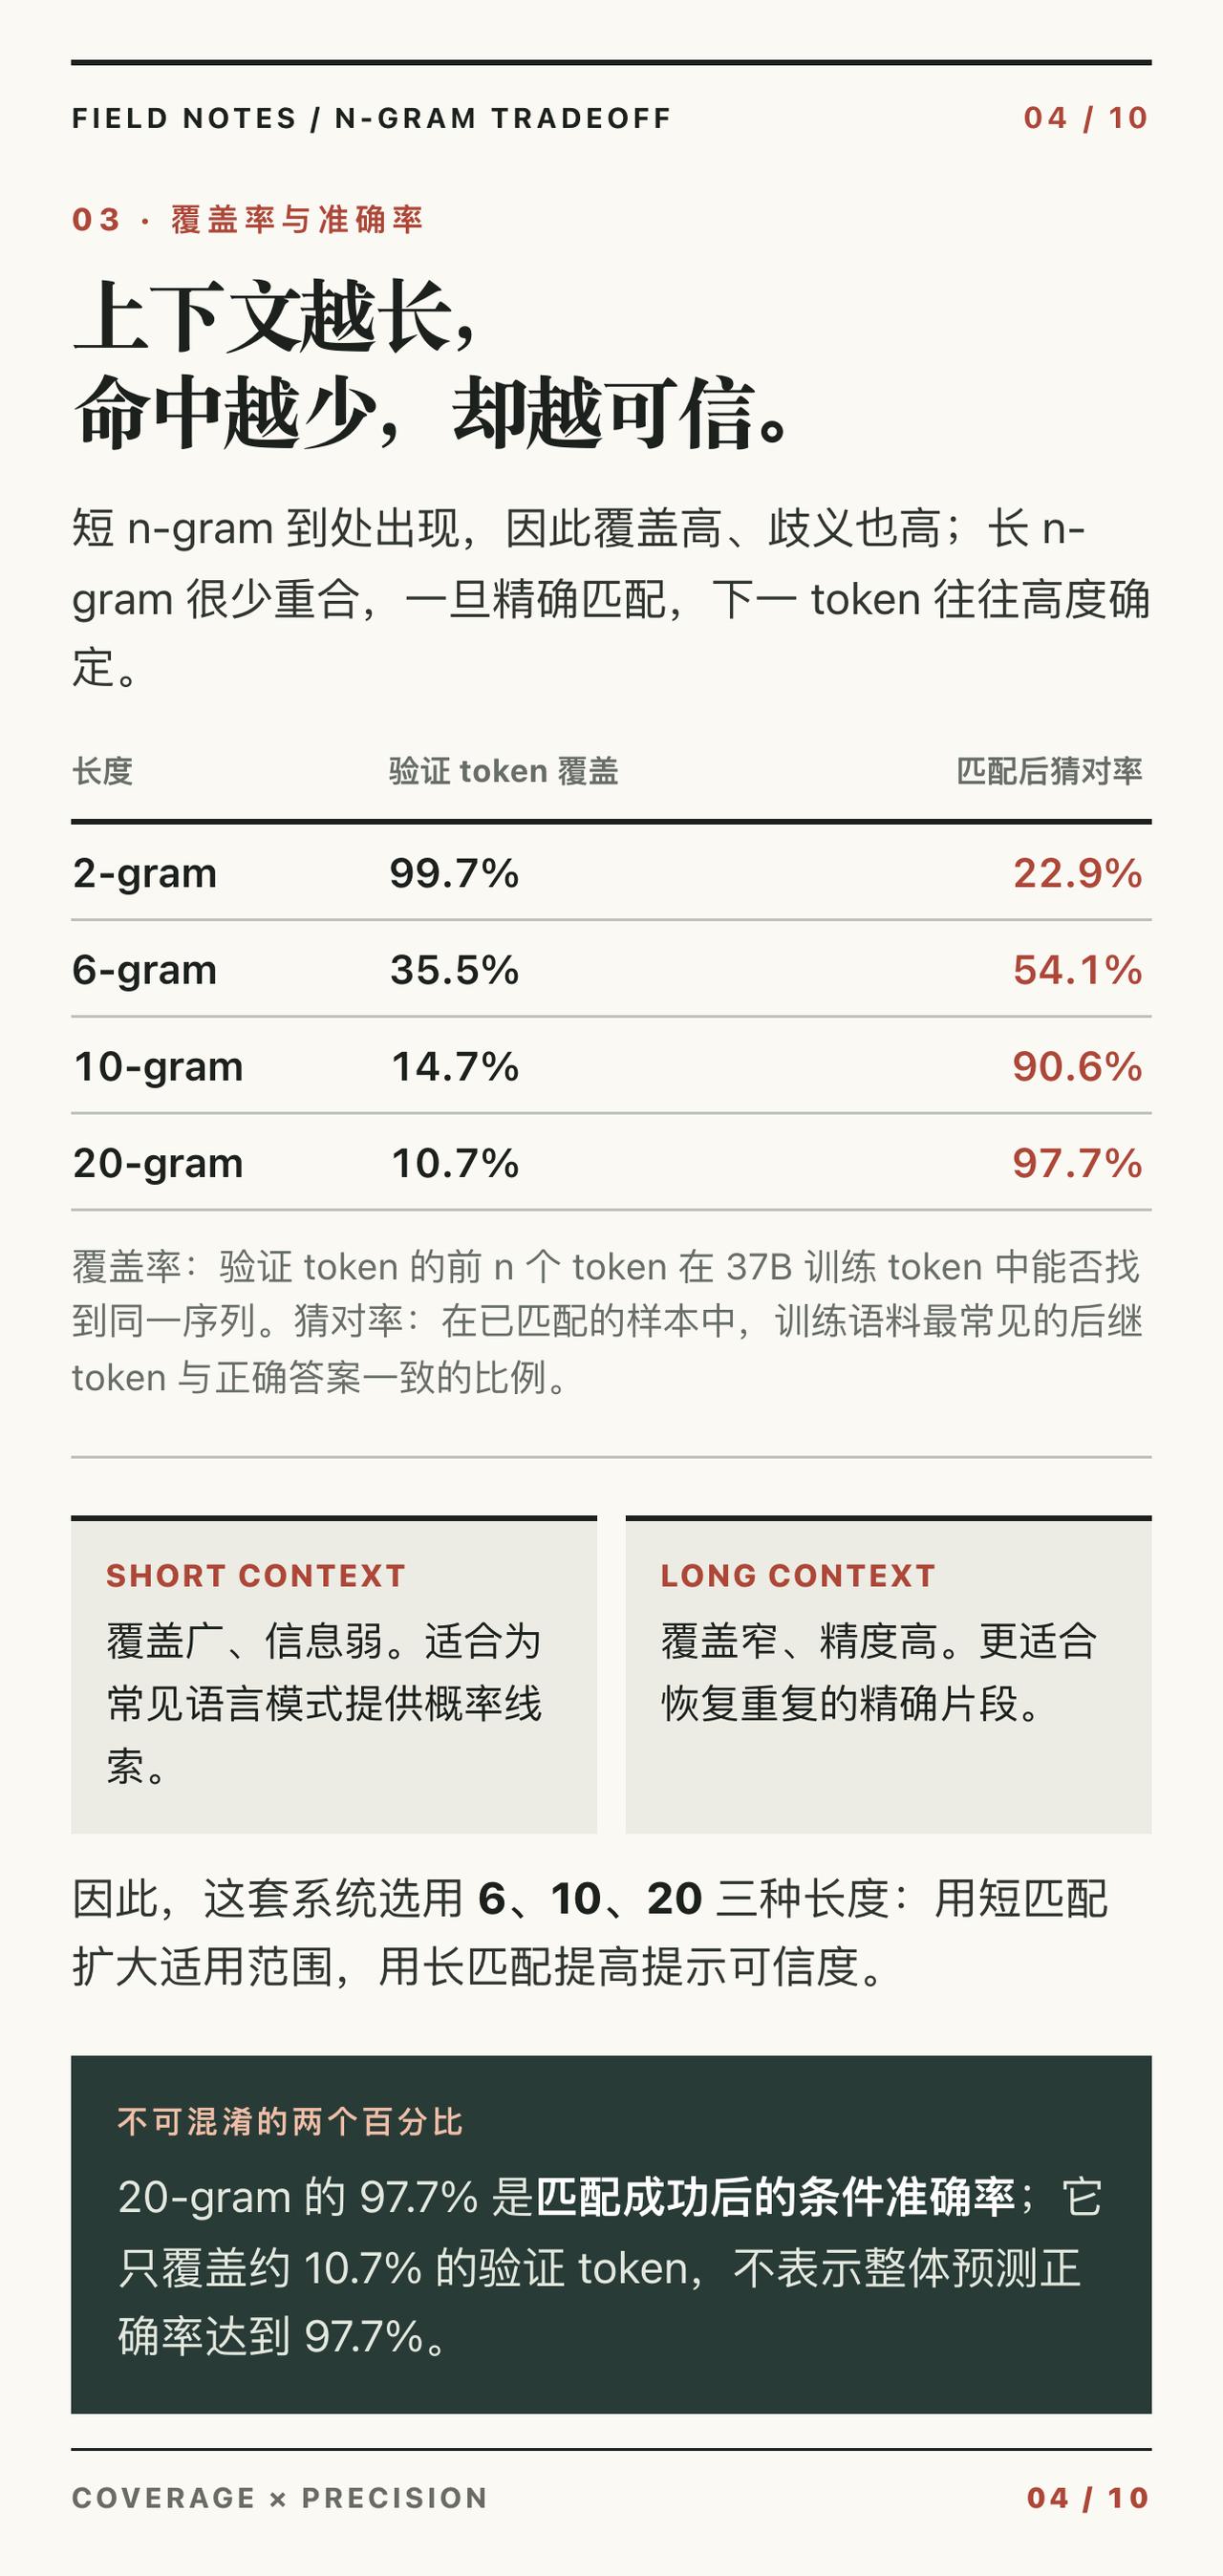
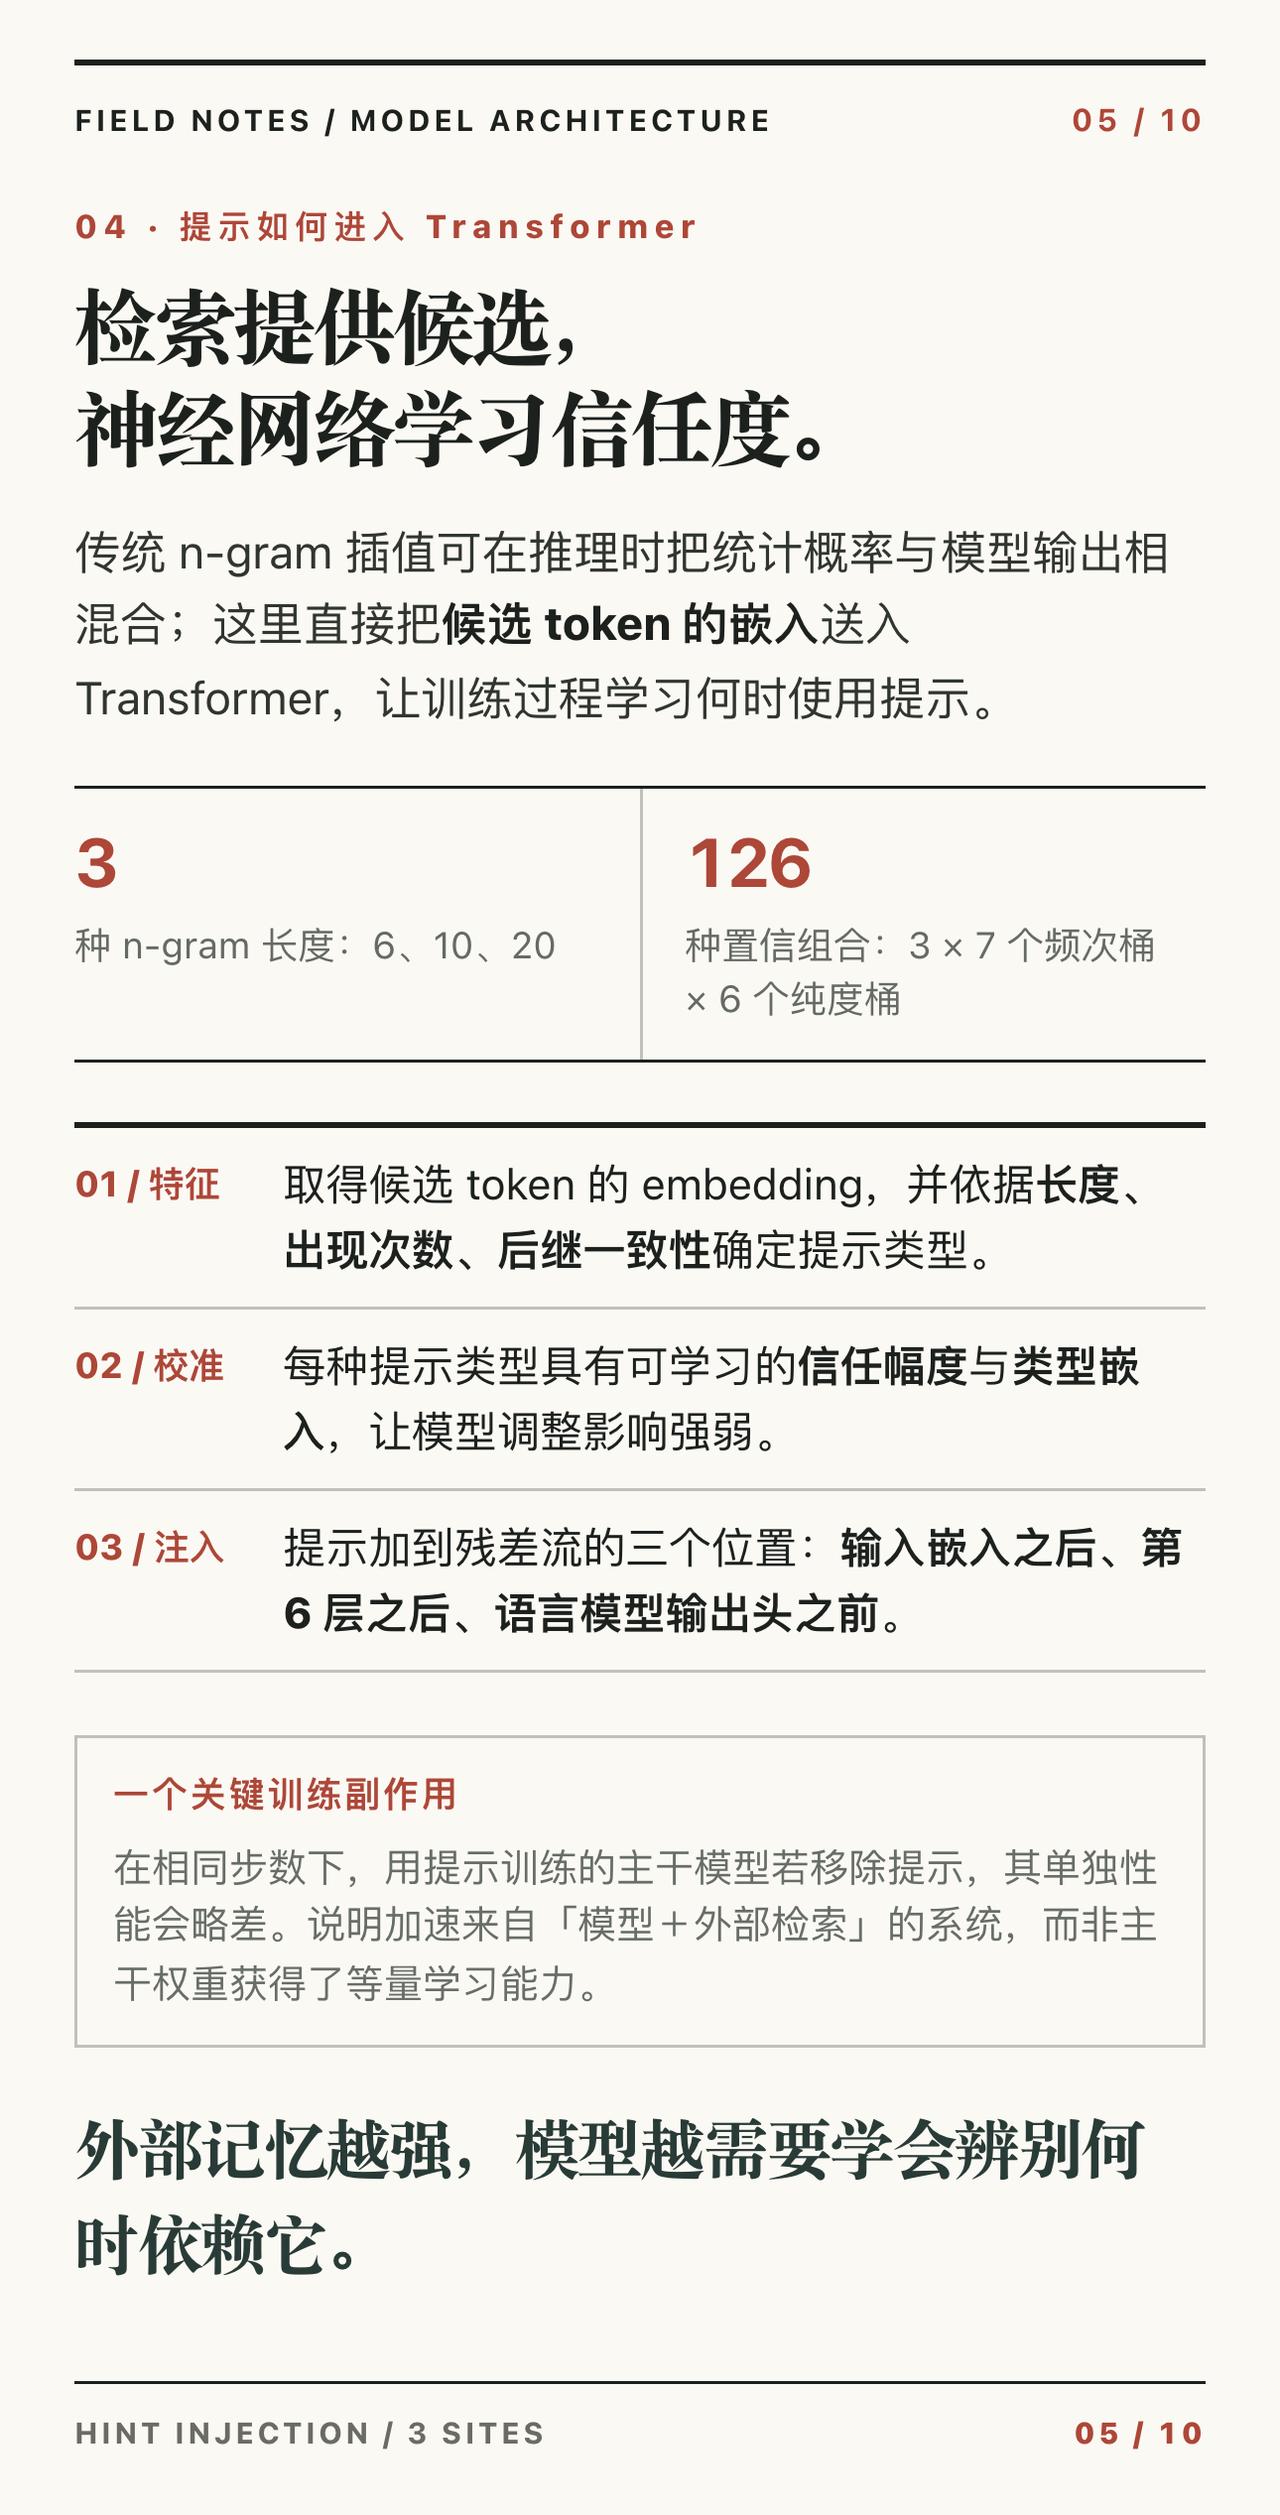
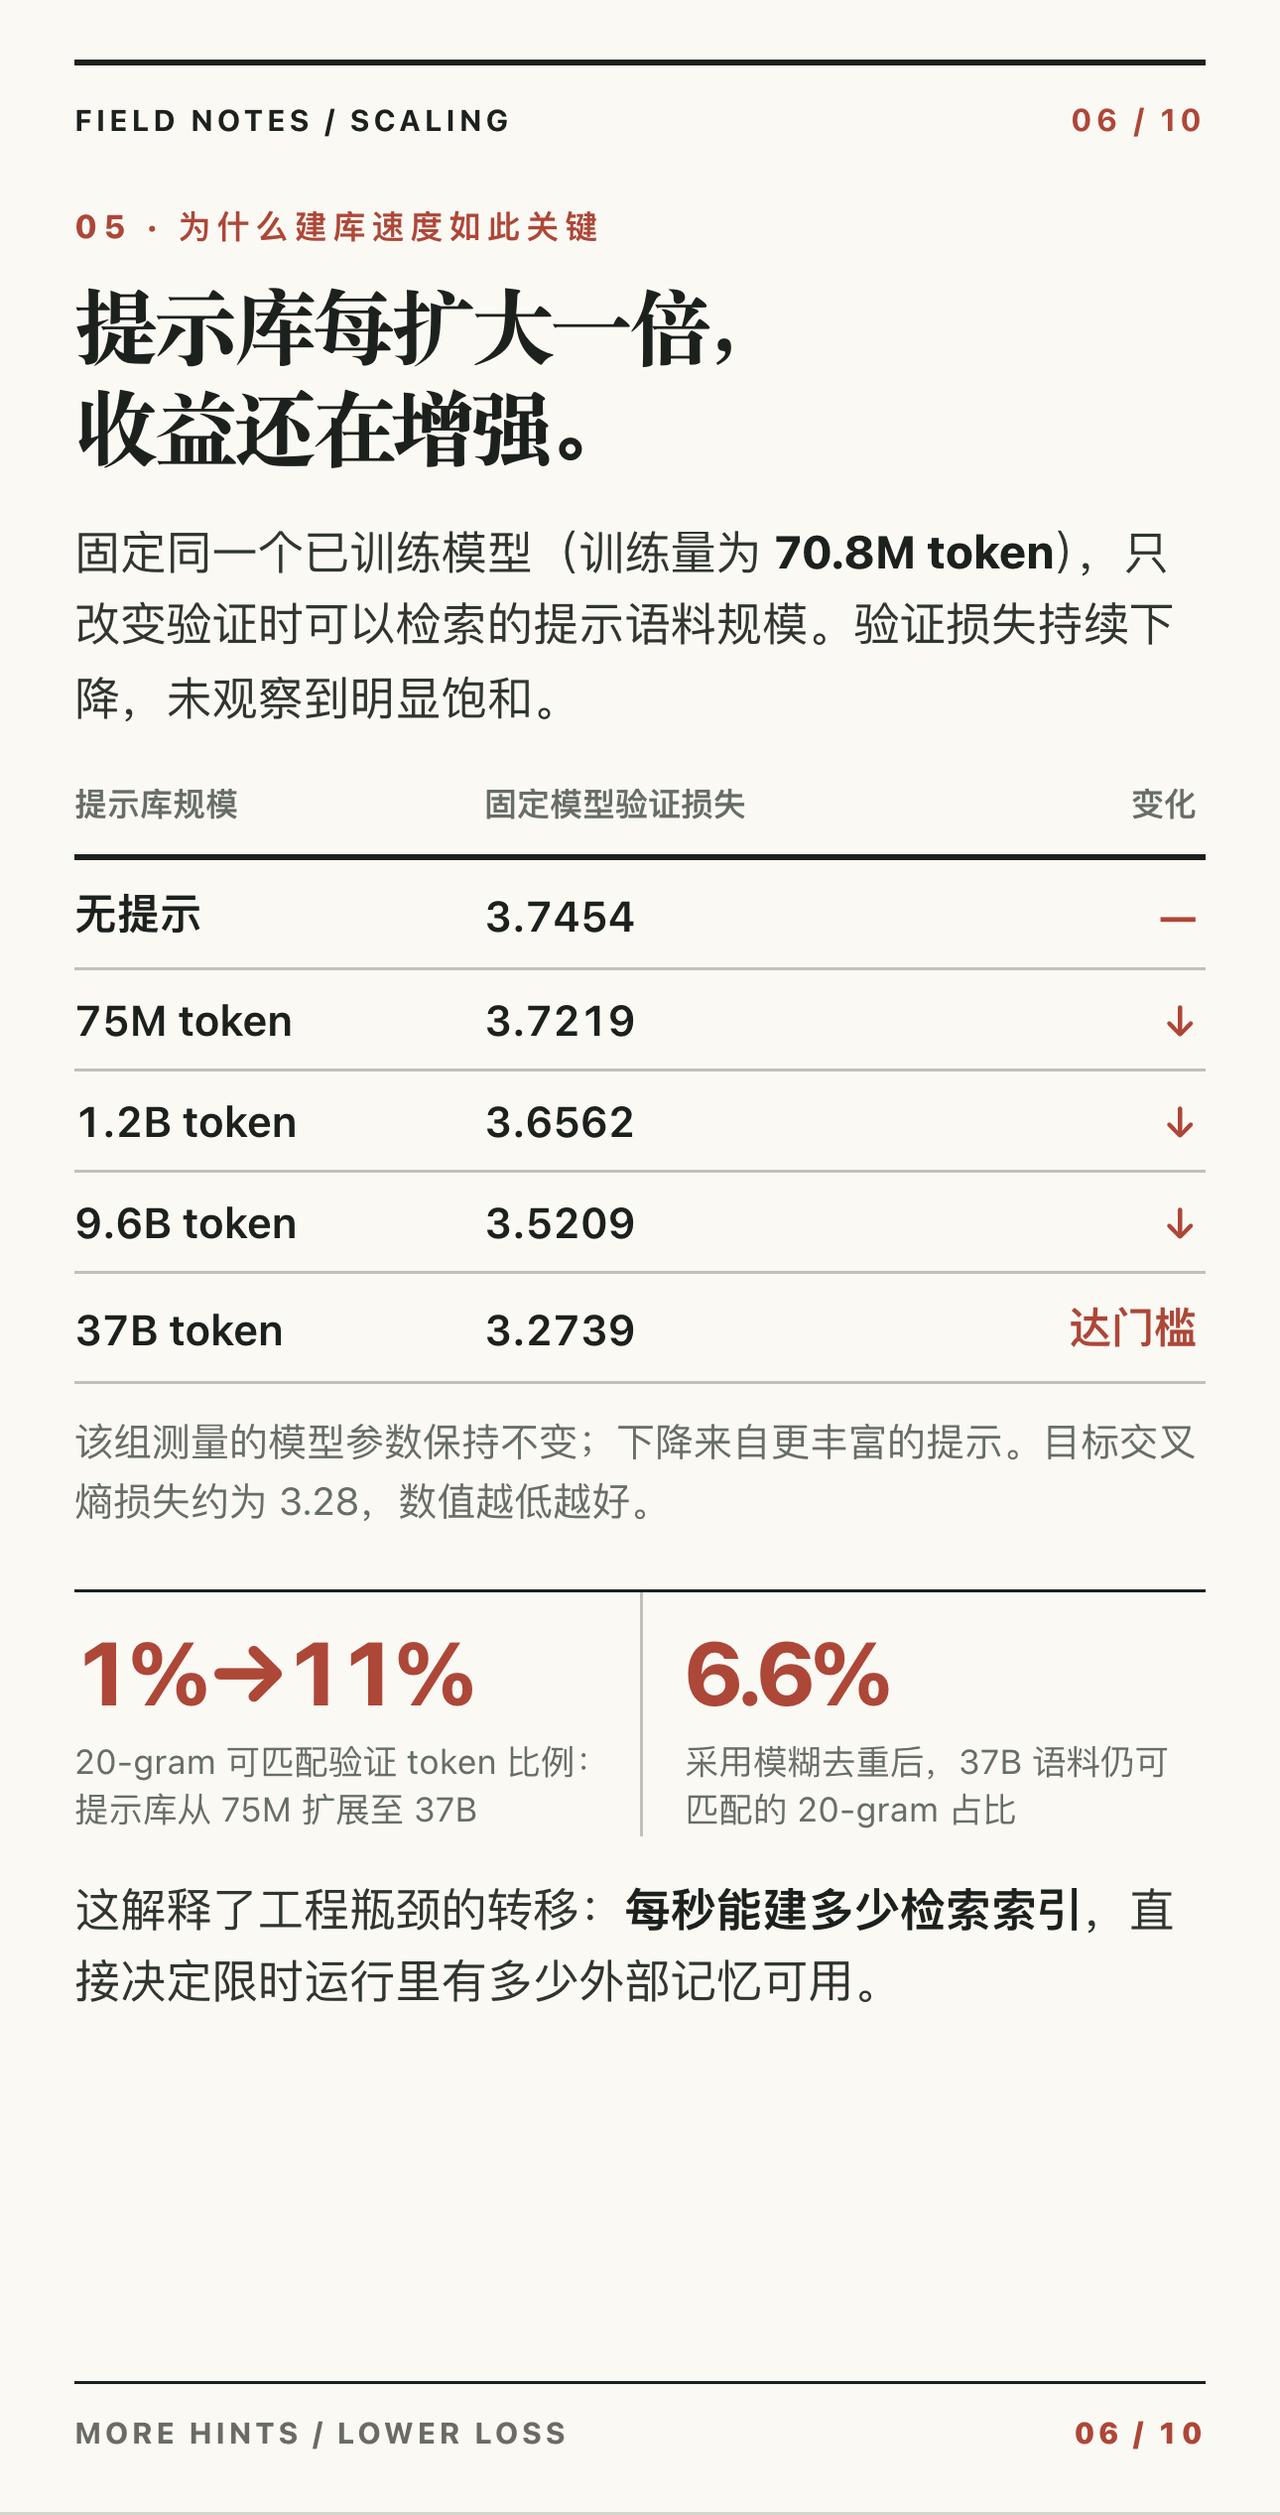
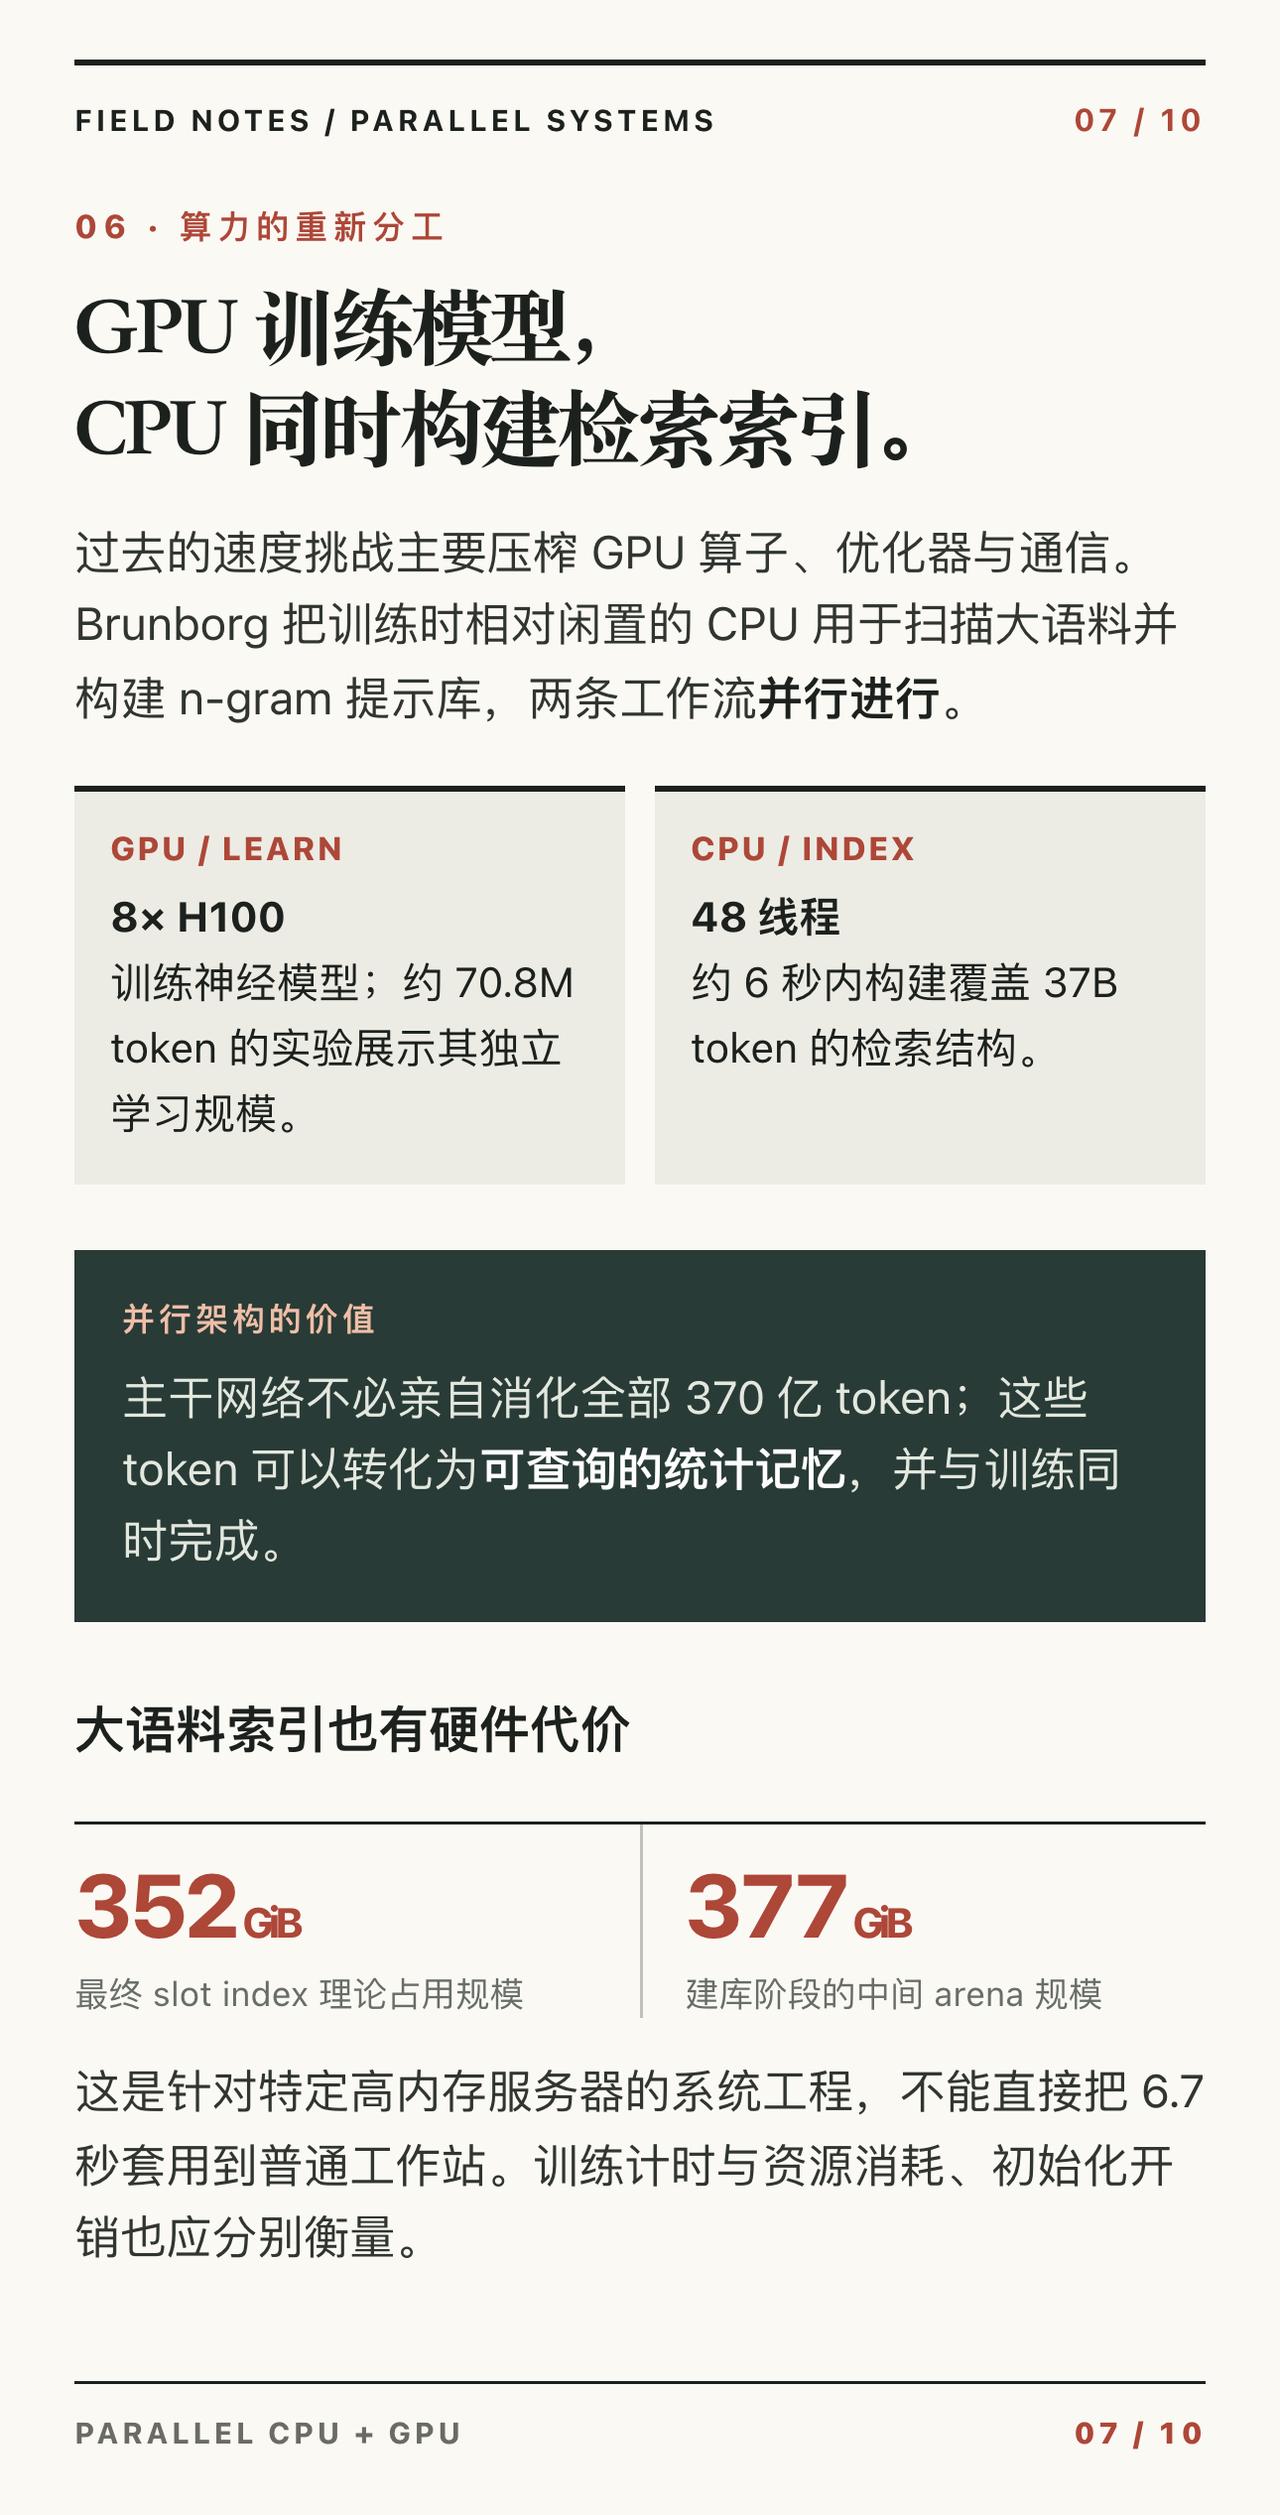
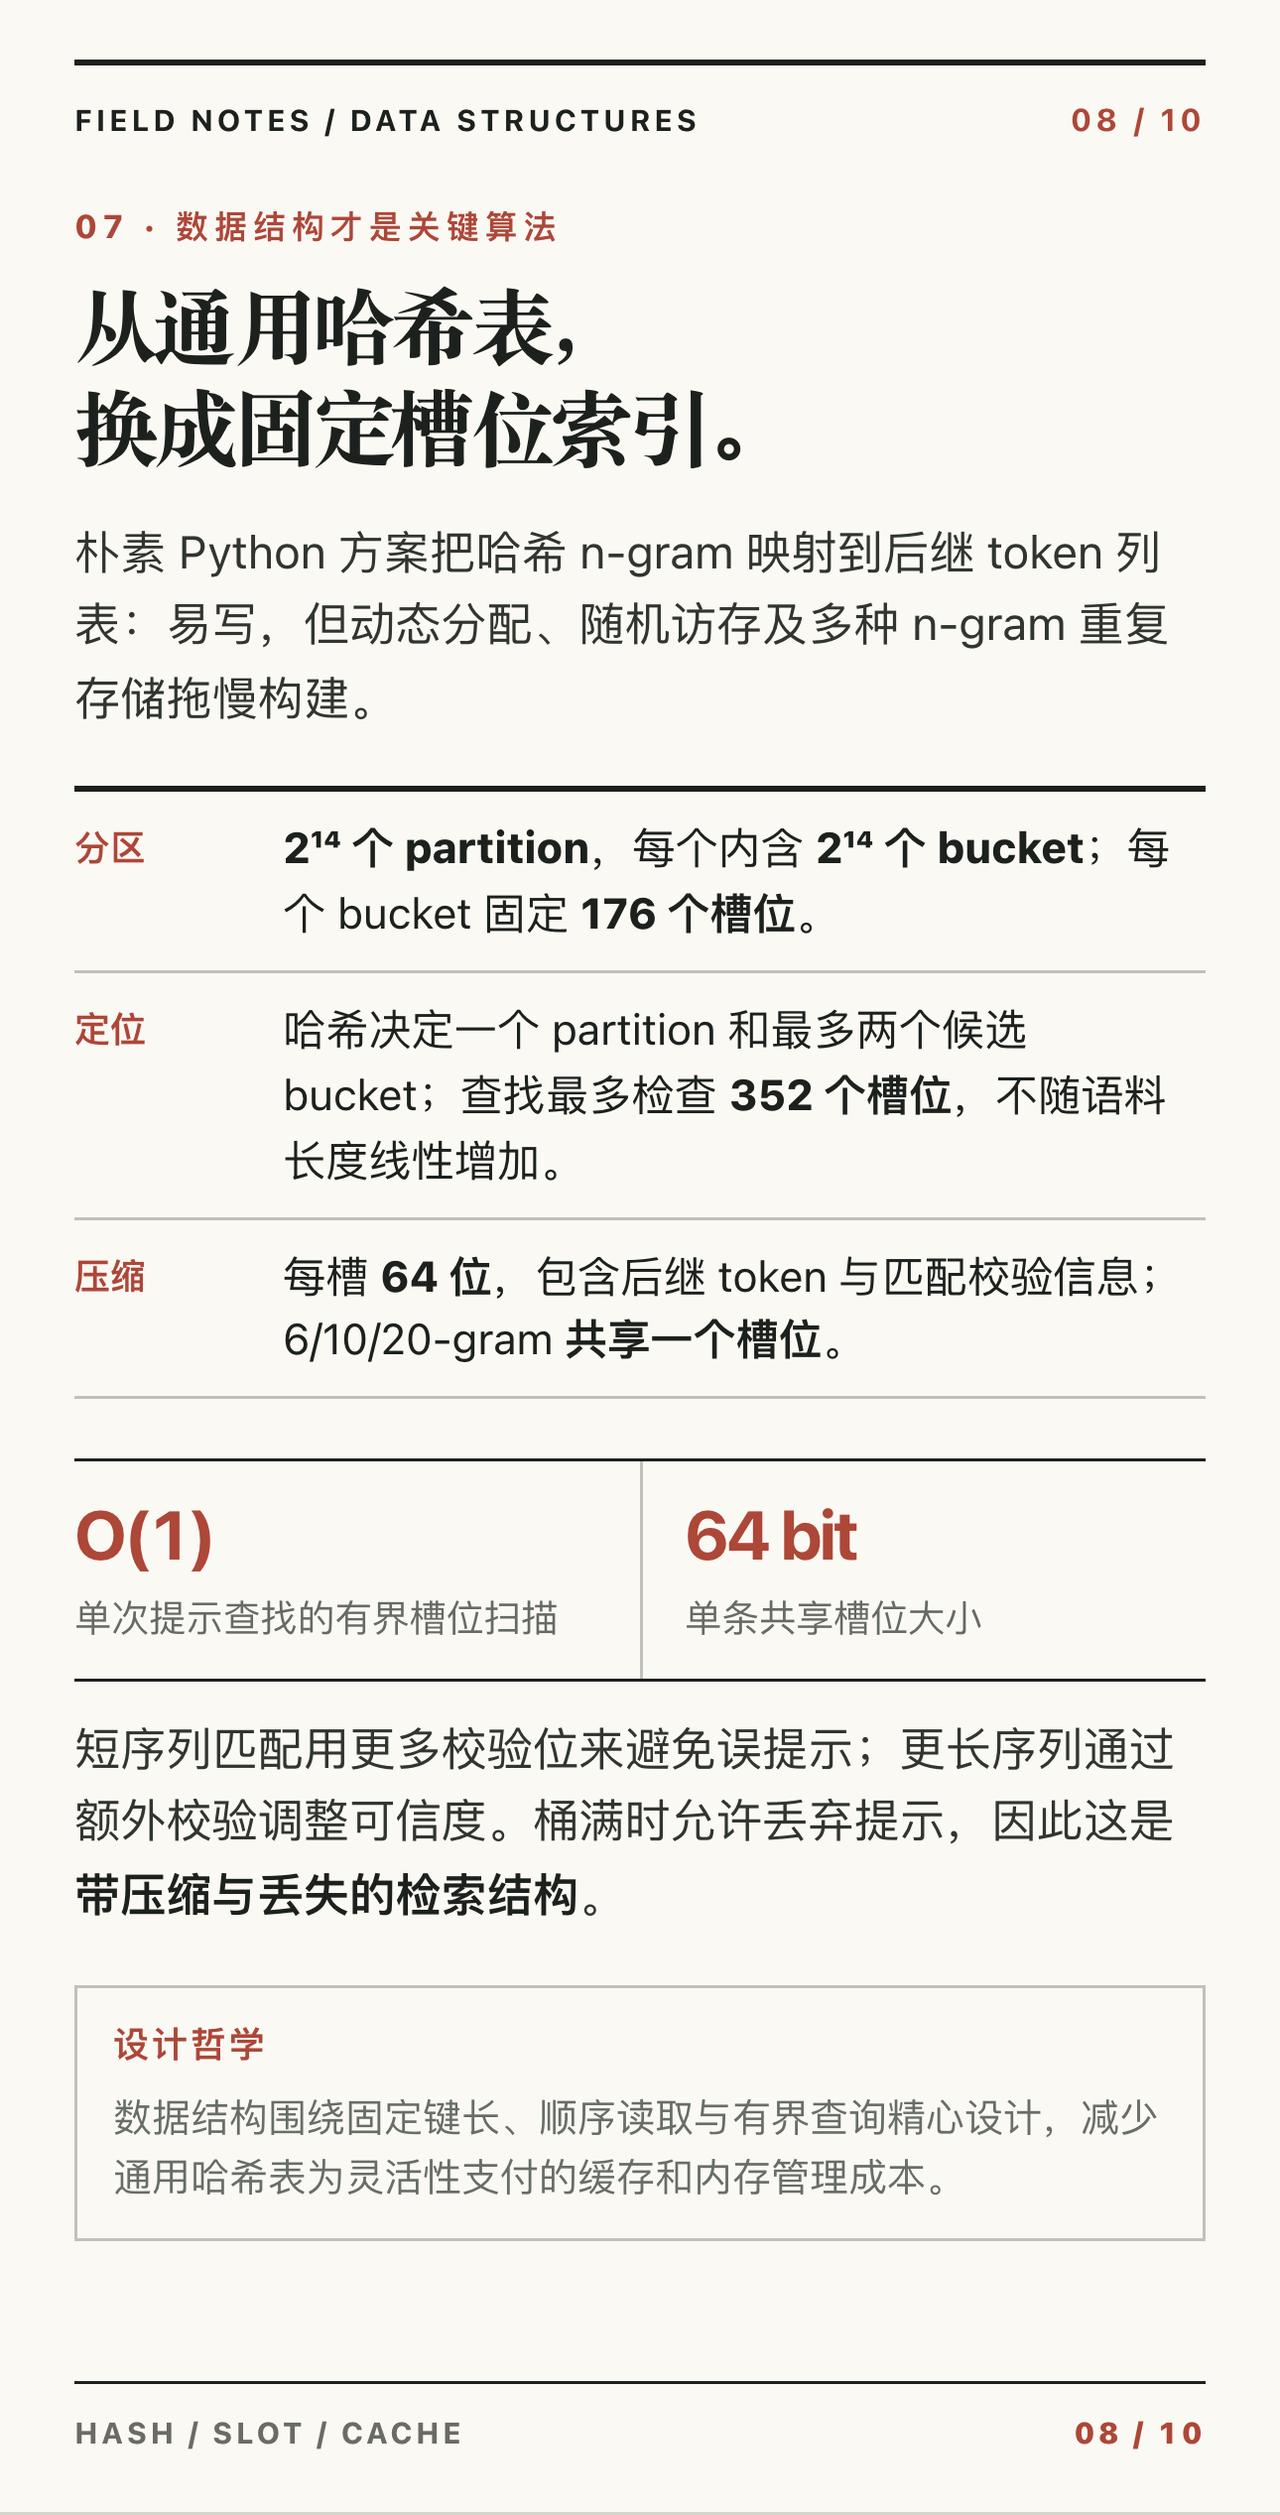
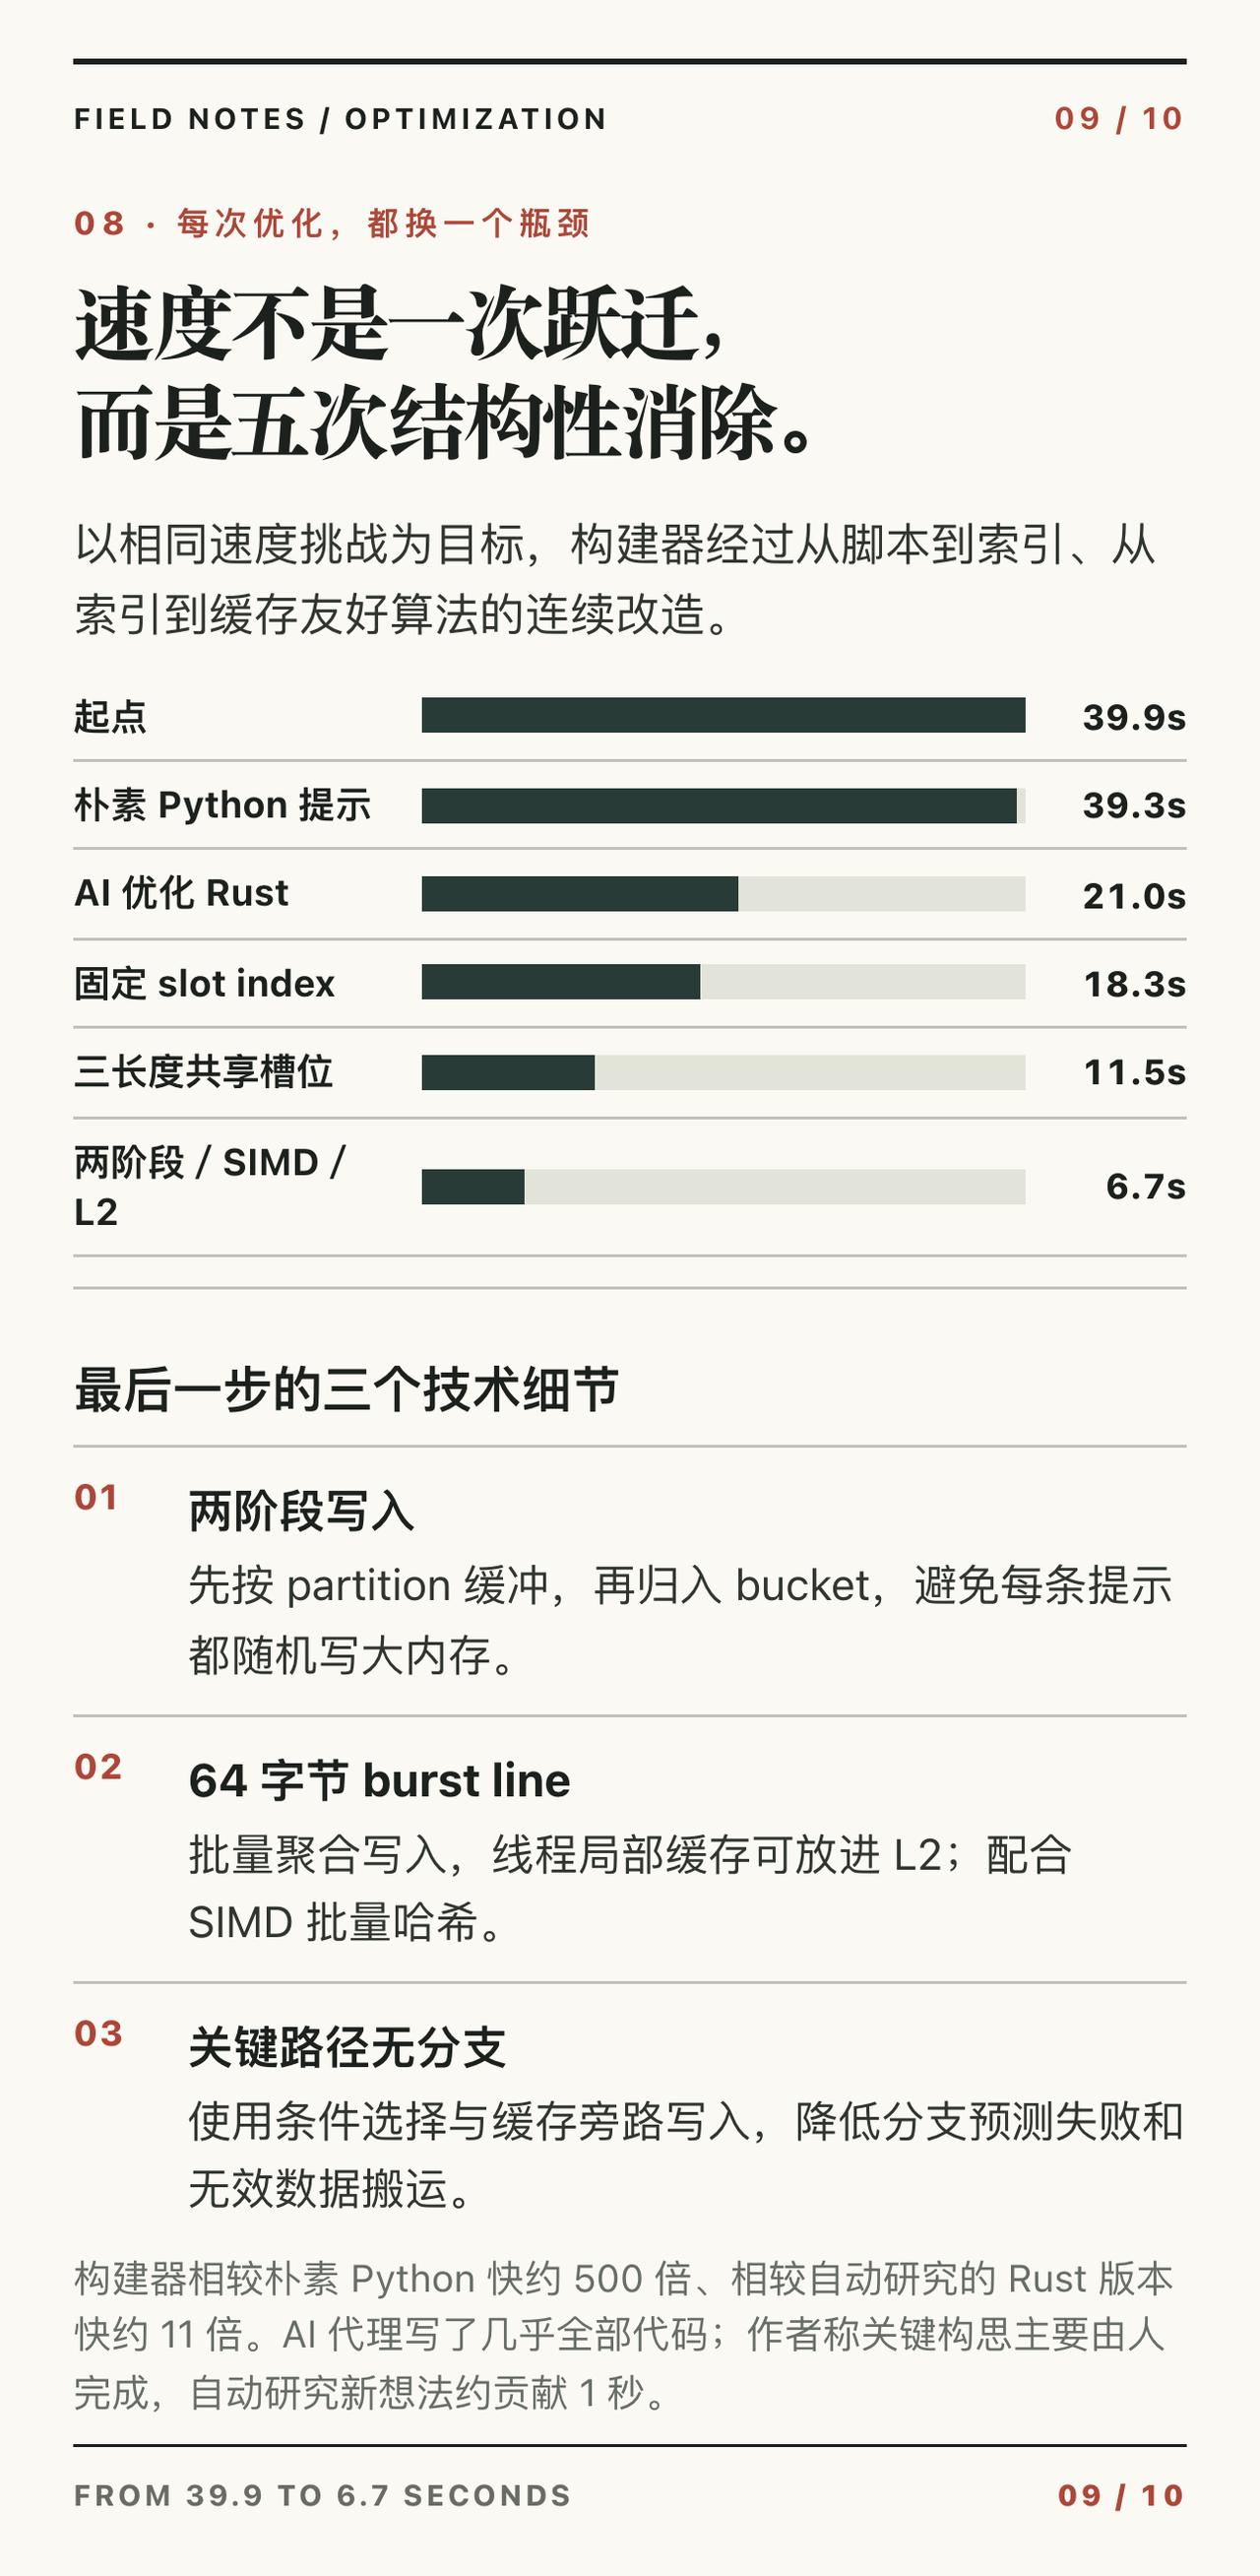
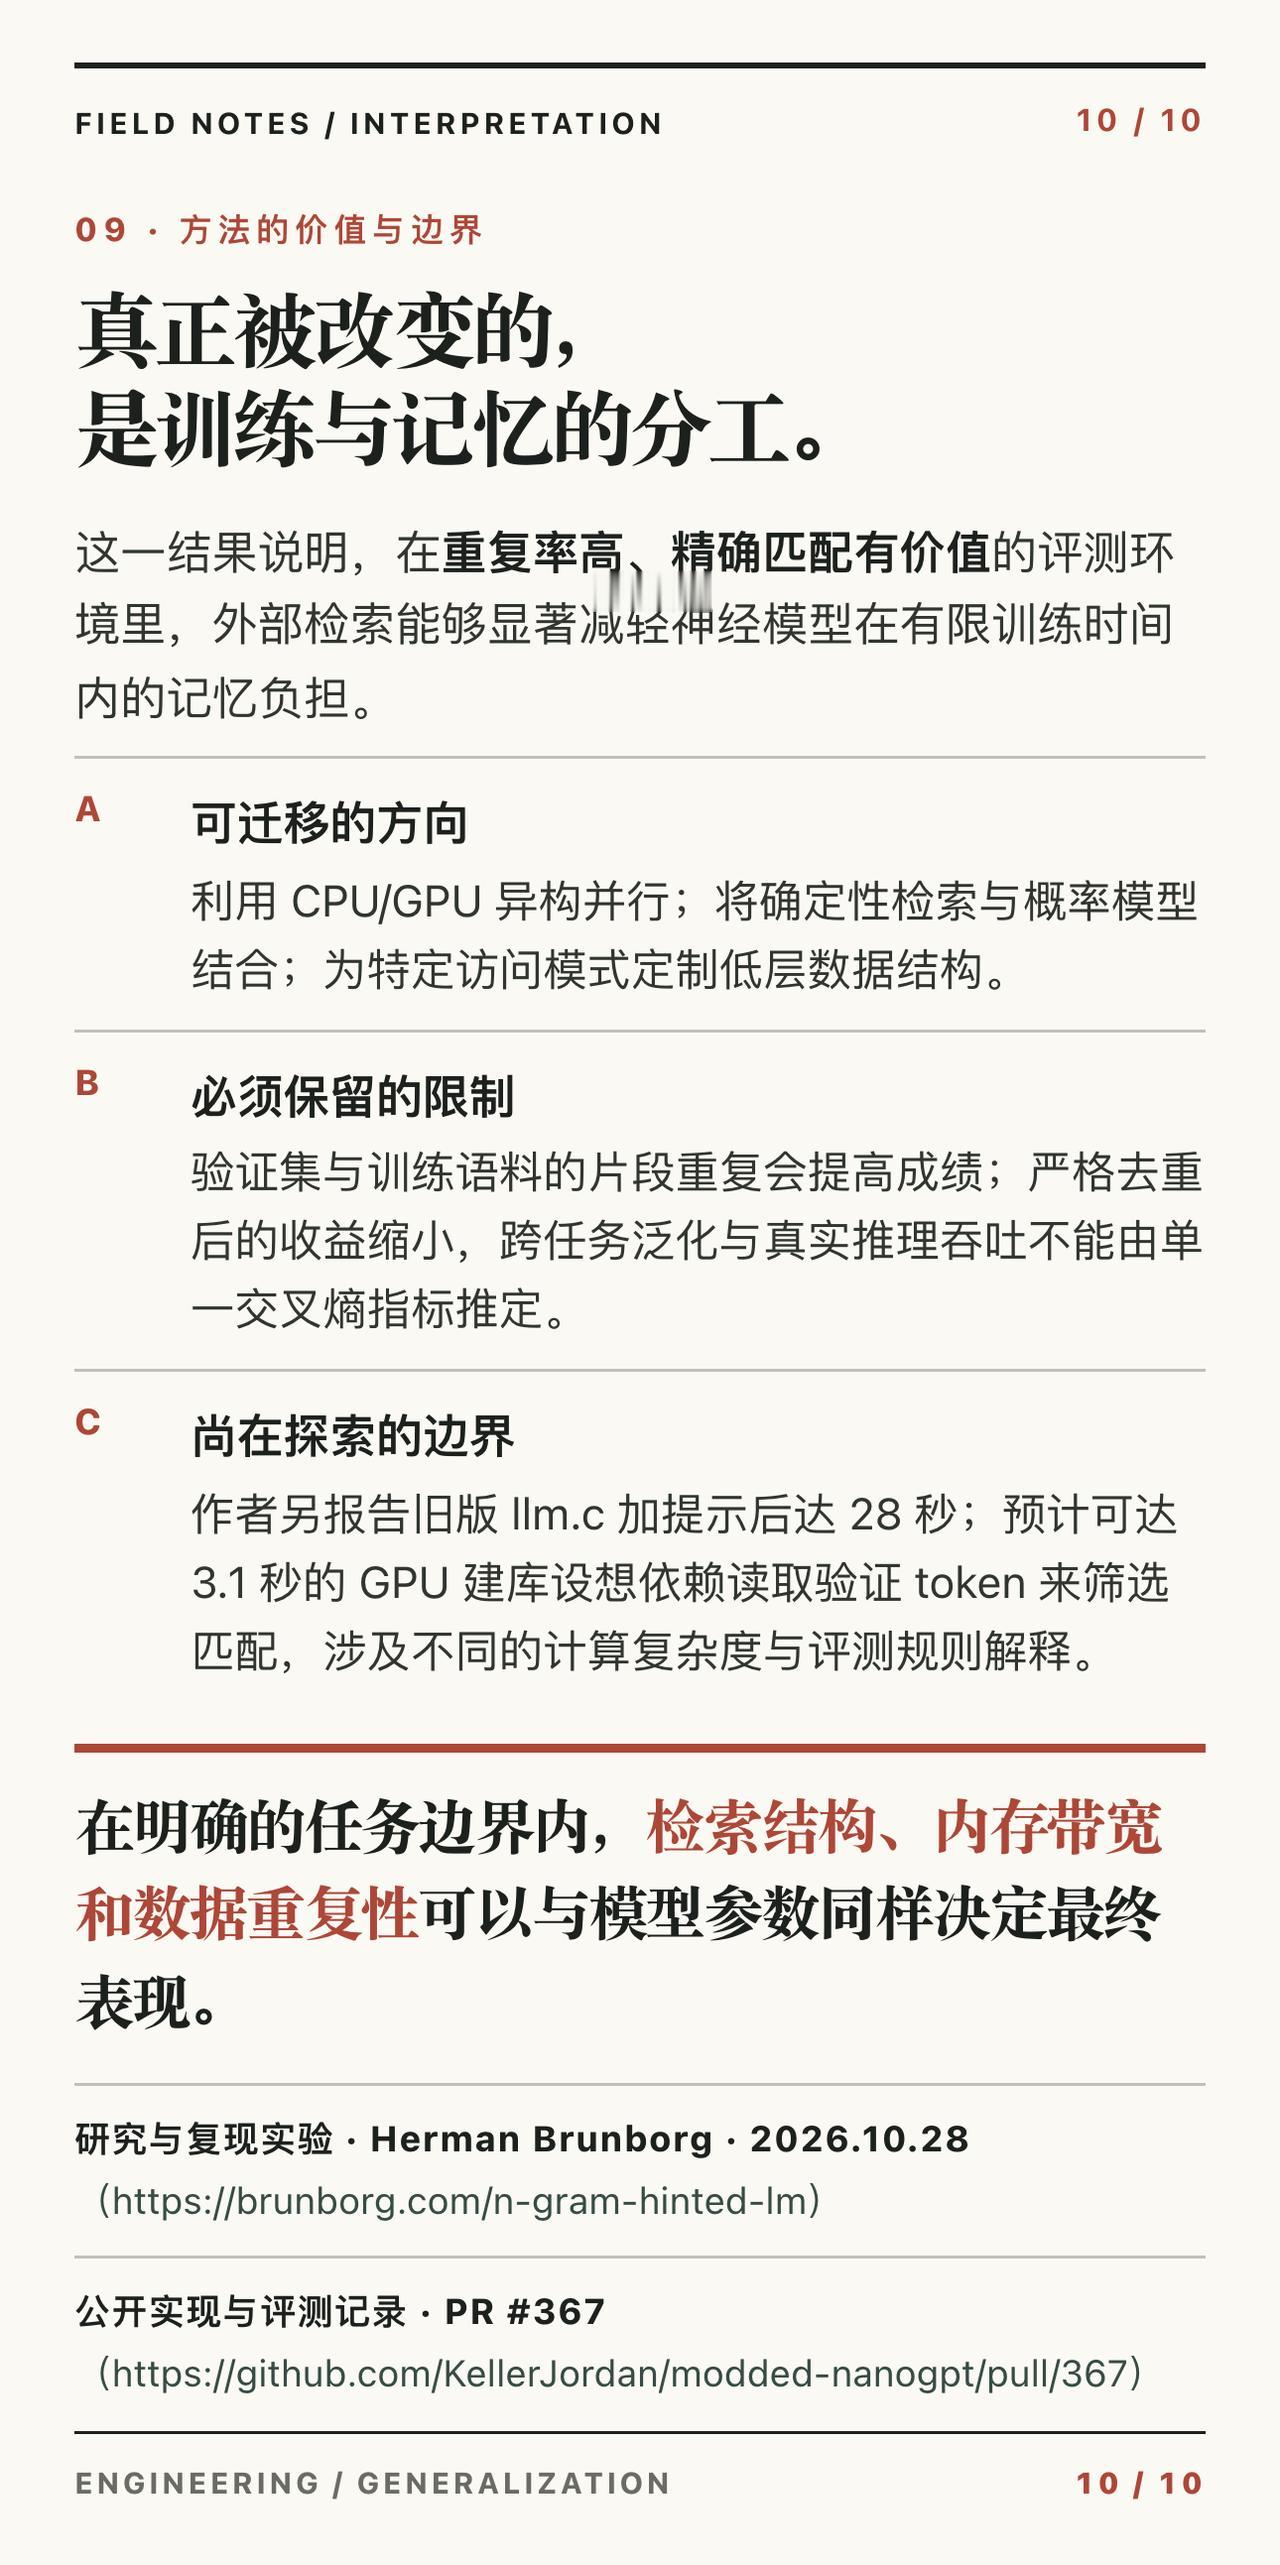
「把NanoGPT训练压进6.7秒的破局思路」在8张H100上,Herman Brunborg将达到目标验证损失的训练耗时从39.9秒压缩至6.702秒。突破的关键不在GPU算子内部,而在系统分工:他利用训练时闲置的CPU,在数秒内扫描37B语料并构建n-gram检索索引,GPU则专心训练主干网络。候选token被注入残差流,模型自己学会何时信任外部提示。低频却精确重复的文本直接交给检索兜底,短时间的训练也就不必再硬背这些权重。底层依托固定槽位等缓存友好的数据结构,把索引构建速度推到极致。这一成果依赖评测集的特征,并不代表通用大模型训练只需数秒,但这套软硬协同、检索增强的设计很有启发。