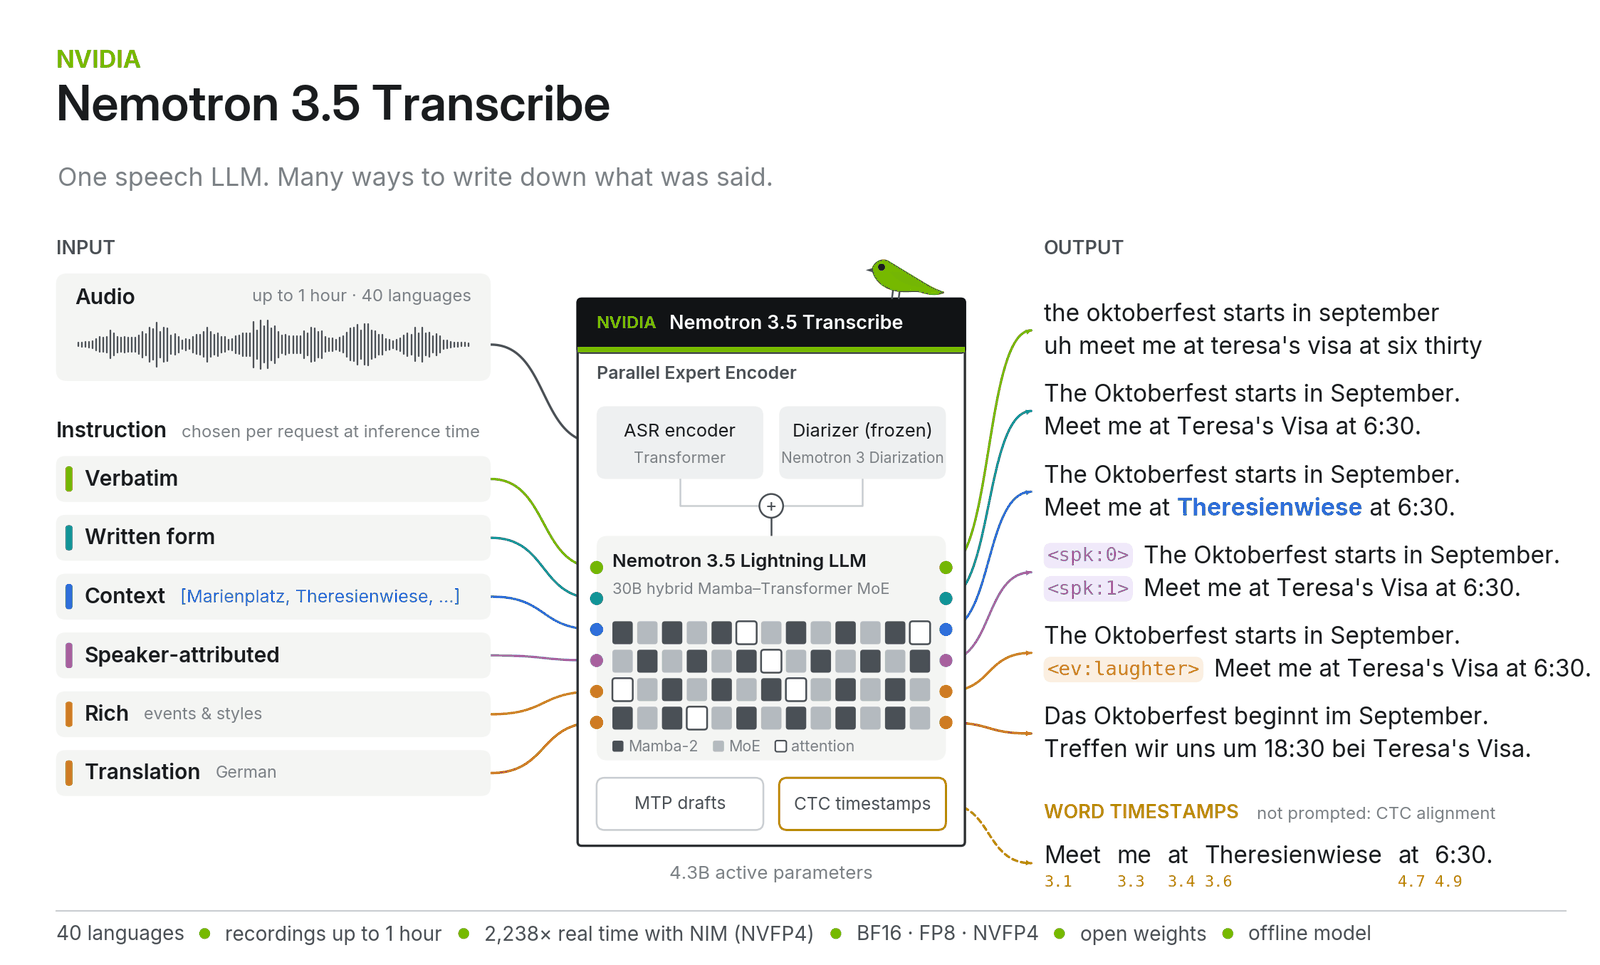
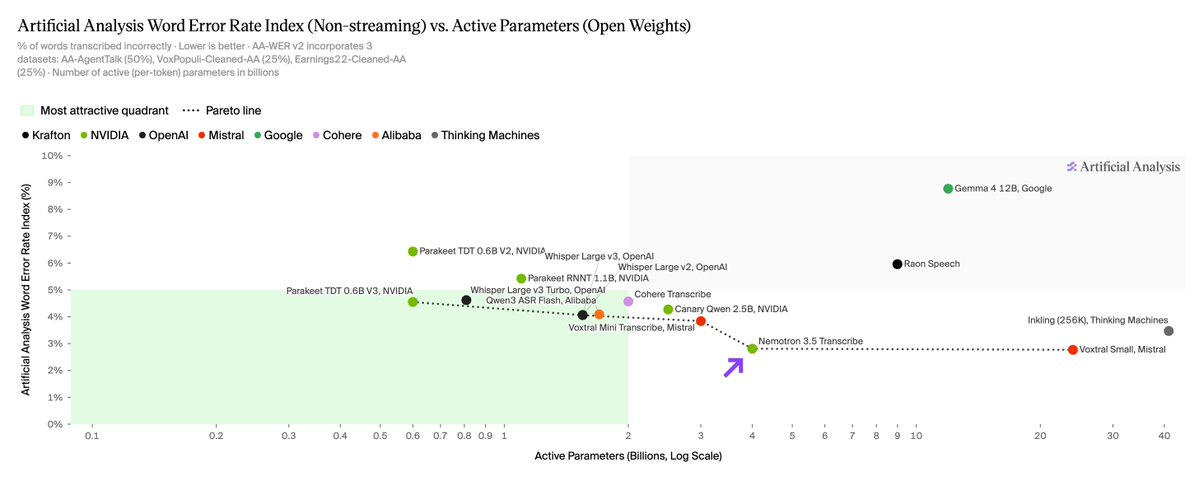
英伟达发布开源语音转写模型 Nemotron 3.5 Transcribe:总参数 30B 的混合专家架构,激活参数仅约 4B,支持 40 种语言非流式转写。在 Artificial Analysis 的 AA-WER 指数上取得 2.8% 字错误率,与Mistral的 Voxtral Small 并列开源第一;在语音智能体对话数据集 AA-AgentTalk 上进一步领先至 1.8%。
Voxtral Small 用约 24B 激活参数拿到 2.77% 的几乎相同精度,Nemotron 3.5 Transcribe 只用六分之一的激活参数就追上了;同体量开源模型普遍还在 4% 左右字错误率徘徊,英伟达上一代最强开源模型 Canary Qwen 2.5B 也只有 4.3%。Hugging Face 开放英语 ASR 排行榜上它以 5.33% 平均字错误率位居开源第一,说话人分离在 VoiceArena 的 14 系统对比和 David AI 多语言基准里同样拿下第一。DeepInfra 托管端点测得 75 倍速度因子——一分钟音频不到一秒完成转写,成本约每千分钟 2 美元。模型把转写、最多 8 人说话人标注、翻译、上下文提示和音频理解塞进同一个检查点,权重、Granary v2 数据和微调配方一并开源;医疗场景微调案例里,相对最佳提示词的字错误率相对下降了 45.8%。
开源语音模型真正缺的从来不是再堆一点精度,而是在可接受成本下把“谁说了什么、能不能立刻改成自己的术语”一次做完。Nemotron 3.5 Transcribe 把激活参数压到 4B 量级却仍能顶住开源第一梯队,说明语音侧的混合专家路线已经开始兑现“小激活、大能力”的承诺!。