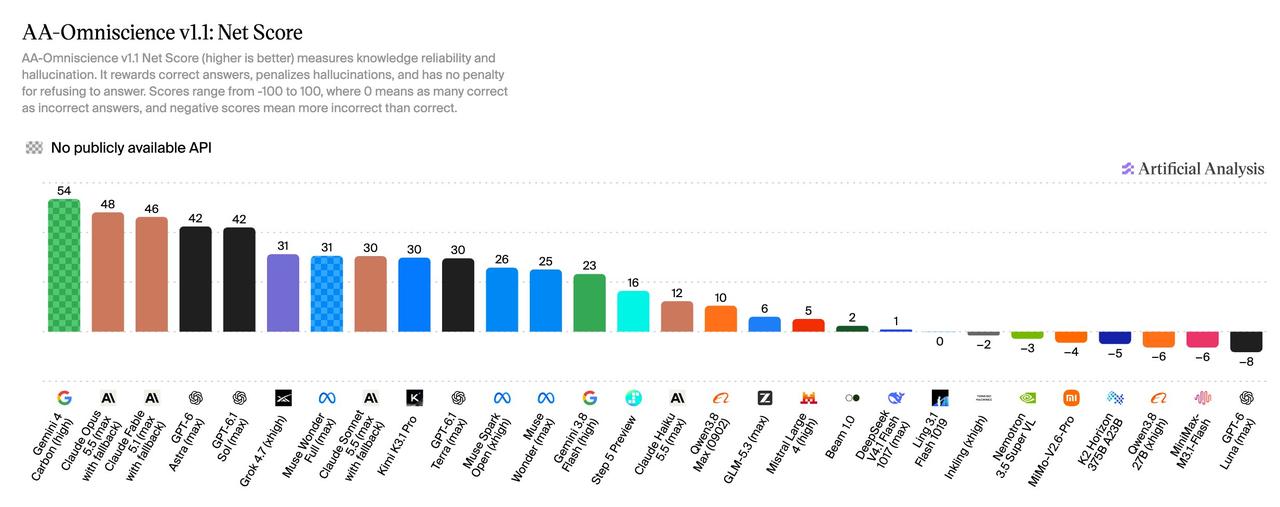
人工智能分析公司发布知识与幻觉基准 AA-Omniscience v1.1。题库从6000道精简至3000道,移除已饱和与公开题目并修正歧义,同步上线校准后的300道公开集。谷歌 Gemini 4 Carbon(高)以净分54位居榜首,Anthropic Claude Opus 5.5 为48,平均得分较v1低约2分。
本次更新的核心在于评分机制与公开集校准。答对加分、答错扣分、承认不知道则中性处理,直接暴露模型在知识边界上的真实可靠性。公开集与私有集净分皮尔逊与斯皮尔曼相关性均达0.99,中位差为0,准确率与幻觉率相关性同样0.99。整体排名与v1高度一致(斯皮尔曼0.98),但刷新题库后多数模型得分下滑,中位降0.6分,平均降1.9分。个别模型跌幅显著:MiniMax M3.1 Flash 从16分跌至-6分,MiMo V2.6 Pro 从8分跌至-5分,意味着错误回答已超过正确回答。幻觉率整体下降1.4个百分点,Gemini 4 Argon(高)最低至4%。准确率方面,Claude Fable 5.1 最高达68%。该基准作为人工智能分析智能指数v5的一部分,覆盖科学工程数学、软件工程、金融、健康、人文社科与法律六大领域。
负分的出现比单纯排名更有信号意义:当模型不愿承认无知、强行作答时,净分会迅速被惩罚拖垮。企业若把这类基准当作选型依据,应优先关注模型在“不知道”时的行为,而非只看绝对正确率。