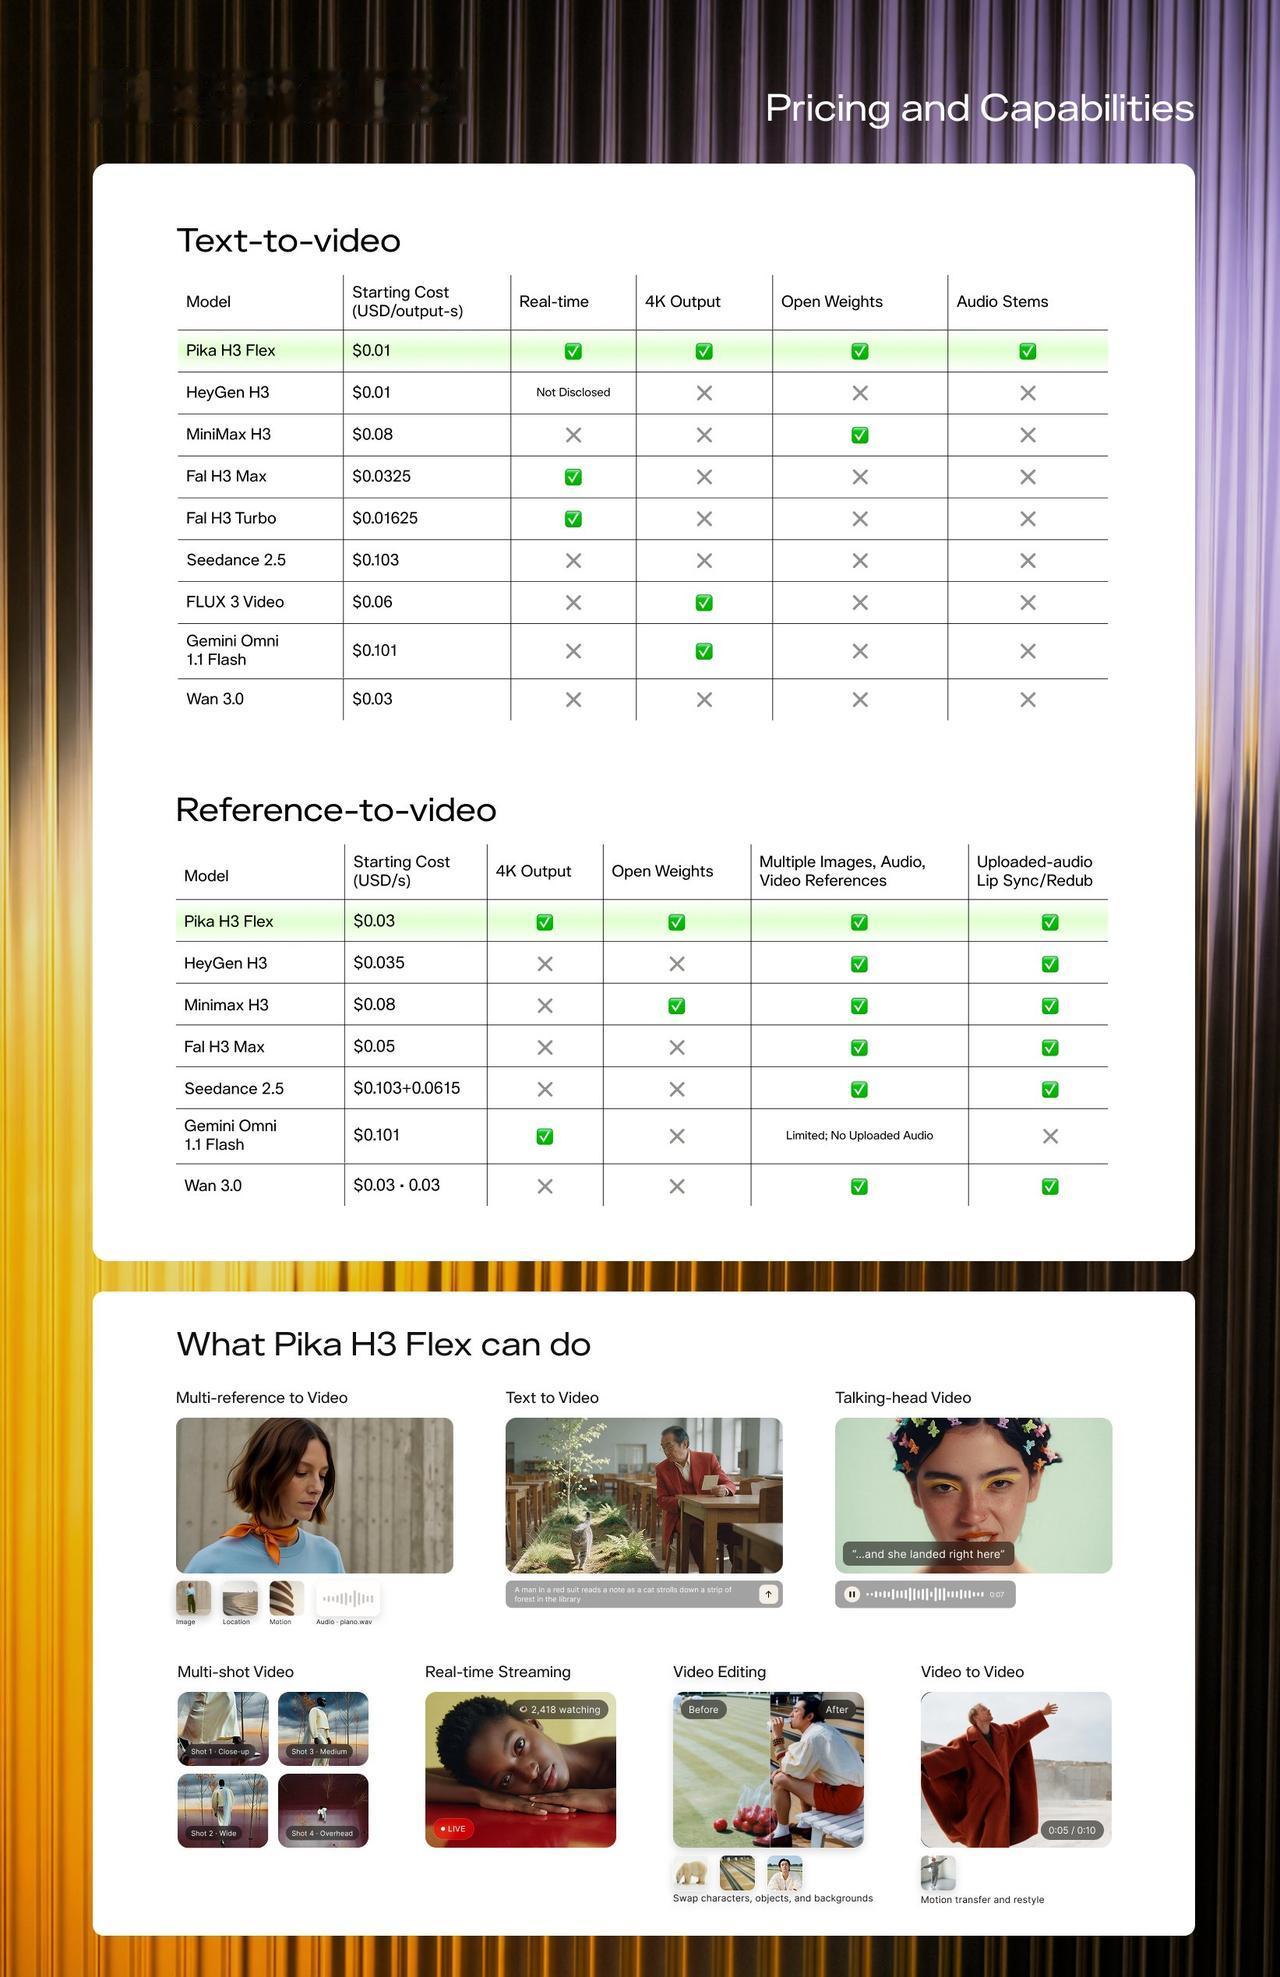
Pika发布开源权重视频模型H3 Flex,基于MiniMax H3后训练,将去噪步数从50步压缩至6步,实现超实时生成,支持最高4K分辨率与同步音频,15秒带声片段最快约7秒出片,API起步价0.01美元/秒。
真正值得展开的是这套后训练路径。团队先在内部精选的音视频数据集上做监督微调,再将生成过程从50步蒸馏到6步;蒸馏后继续用奖励学习与偏好优化,专门打磨美学、画面清晰度与指令跟随。速度上,768p分辨率下DiT去噪平均比Fal H3 Max快约1.8倍,10秒与15秒文本/图像到视频场景接近2倍。质量并未因步数骤减而滑坡:自动化评测中,H3 Flex在五项视觉与音频指标上多数提示词优于MiniMax H3、Fal H3 Max 和 HeyGen Video;视频美学一项更是在91%的提示词上压过H3 Max。盲测人类偏好里,它在人体解剖、复杂构图、音频同步,以及参考视频的风格与运镜上同样领先。权重已同步上线 Hugging Face,支持ComfyUI与diffusers,本地可直接跑480p/768p。