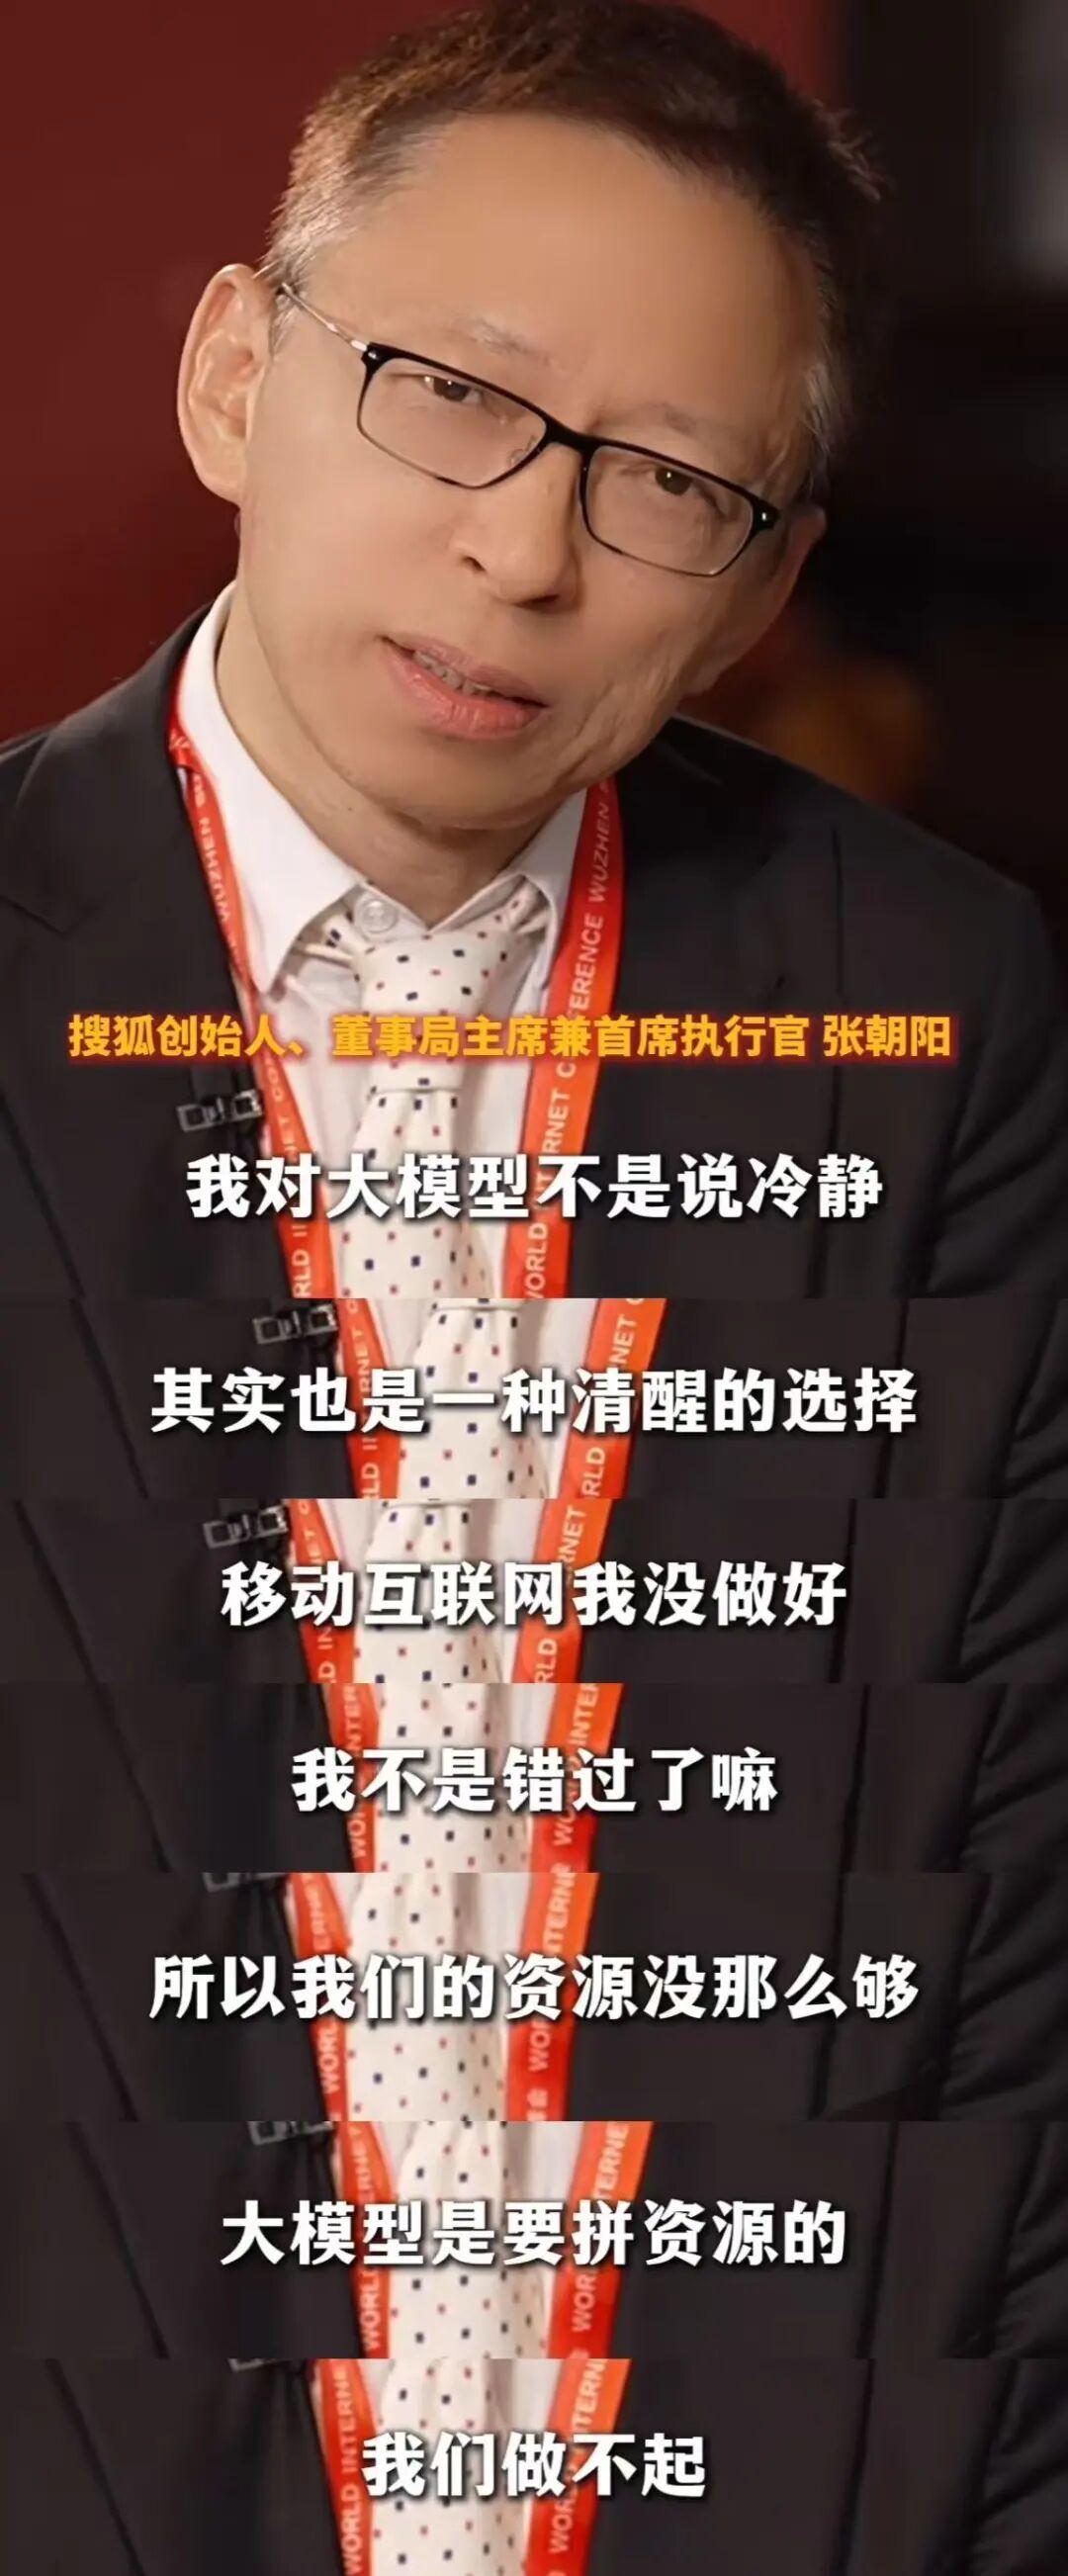
在2026年乌镇世界互联网大会的现场,搜狐创始人张朝阳说了一句久违的大实话:“我们做不起大模型。”
他坦言,因为自己当年错过了移动互联网,导致搜狐如今积累的资源有限。而大模型是一场极度依赖算力和资金的资源游戏,“我们资源没那么多,做不起。”
在如今满屏都在喊“All in AI”、恨不得连卖煎饼果子都要挂个神经网络大模型概念的互联网圈里,张朝阳这番表态显得格外接地气。
这两年的互联网圈,AI几乎成了所有发布会的标配,做电商的要搞AI导购,做内容的要搞AI生成,连做本地生活的都要加个AI选址功能,仿佛只要贴上大模型的标签,公司就自动拿到了下一个时代的船票。至于到底有没有核心技术、能不能落地赚钱,反而没多少人较真。
很多人觉得张朝阳这是认怂,可这本质上就是一道再直白不过的算术题。大模型从来不是靠产品创意就能弯道超车的赛道,完完全全是真金白银堆出来的军备竞赛。
行业里的公开数据摆在那:训练一个千亿参数级别的通用大模型,仅单次预训练的算力成本就要几千万美元;要是往万亿参数的第一梯队冲,一次完整训练烧掉上亿美元都是常态。
这还只是入门门槛,后续的模型迭代、数据采购、日常推理运维,再加上顶尖AI人才的薪资,每一项都是持续出血的无底洞。有机构估算过,要维持一个主流大模型的长期研发和运营,每年的投入至少在10亿美元以上。
再看看搜狐的家底,这笔账就更清晰了。2025年搜狐全年总营收才5.84亿美元,大半收入还得靠游戏业务撑着,就算把一整年的营收全砸进去,恐怕连一轮顶级大模型的训练成本都覆盖不了。
真要是头脑一热跟着喊All in AI,搞不好把现有业务的现金流都拖垮,最后落个鸡飞蛋打。
张朝阳作为经历过互联网几轮兴衰的老兵,当然算得清这笔账,他说的“做不起”,不是不想做,是知道硬挤进去只能当陪跑的分母。
更有意思的是,现在行业里明明绝大多数公司都做不起大模型,却个个都装作势在必得的样子。不少公司所谓的AI布局,说白了就是买个现成的大模型接口套层皮,就敢对外宣传自研核心技术,只为了在资本市场讲个新故事。
反正多数投资者也分不清大模型和关键词检索的区别,只要公告里带上AI两个字,股价就能涨一波,股东减持套现的钱,比踏踏实实做三年业务赚得都多。在这种炒作风气里,敢直白说“我不凑这个热闹”的,反而成了稀有的异类。
当然,不做基础大模型,不代表搜狐就彻底和AI脱节了。张朝阳选的路其实很务实:不砸钱赌底层研发,只把AI当成提效工具用。
比如他自己的物理直播课,早就用上AI生成字幕、整理课件素材;搜狐的内容和游戏业务,也在通过AI工具降低运营成本、提升生产效率。不用赌上全部身家去博一个不确定的未来,只拿新技术给自己的主业赋能,这笔买卖怎么算都不亏。
其实回头看,张朝阳说“错过移动互联网”,半是事实半是谦虚。作为中国互联网的初代玩家,他见过门户时代的辉煌,也经历过泡沫破裂的寒冬,比谁都清楚风口的本质。
每个时代都有每个时代的狂欢,但不是所有公司都有资格当领跑者。比起一窝蜂地喊口号、追热点,先想清楚自己有什么、能做什么,反而更重要。毕竟互联网发展了二十多年,最后活下来的,从来都不是喊得最响的,而是活得最清醒的。