多模态视频记忆短板➕科研干货
很多人觉得多模态大模型看懂视频画面就够了,但做Video Agent、视频多轮对话才会发现一个致命问题:
聊到后面,模型会忘掉前面聊过的信息!
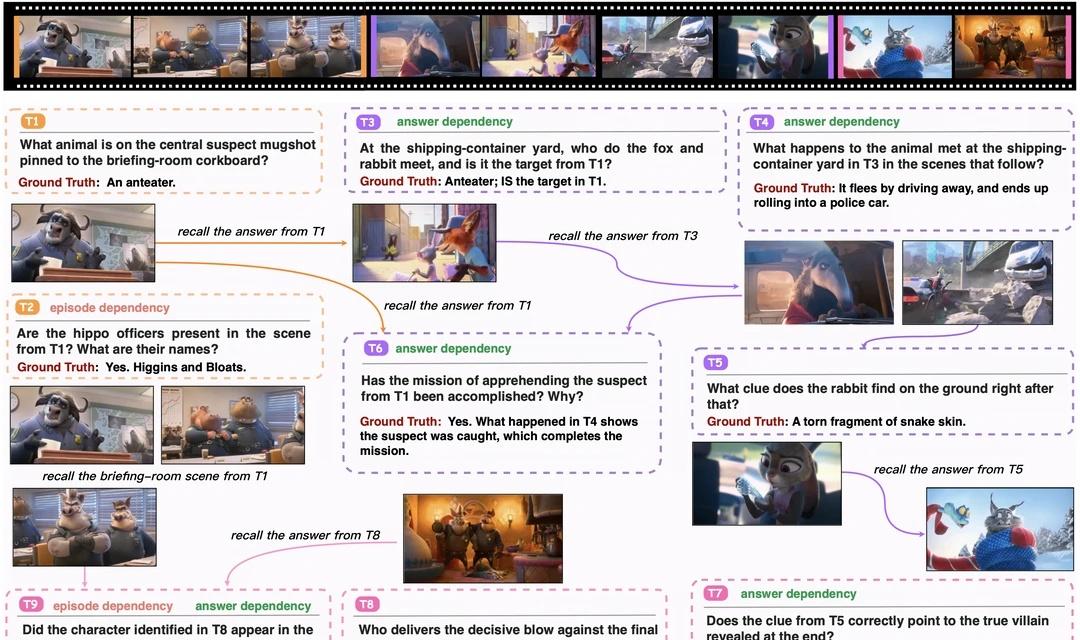
举个很直观的例子:
我们先问模型视频里的一个角色,隔好几轮对话之后,再回头追问这个角色相关信息
它明明看懂当下画面,却没办法把当前问题和之前的对话历史串起来
这个研究最核心的价值,是把「视频里的记忆」拆成了两种依赖,这个思路特别值得学:
场景依赖:要召回之前某一段画面片段,再回答新问题
答案依赖:要召回模型自己上一轮给出的结论,顺着这条链继续推理
和普通视频QA不一样!
普通评测的问题都是独立的,单看画面就能答;
而这个benchmark专门设计了链式关联的多轮问答,后面的问题必须依赖前面对话信息,用来考验模型的上下文记忆能力
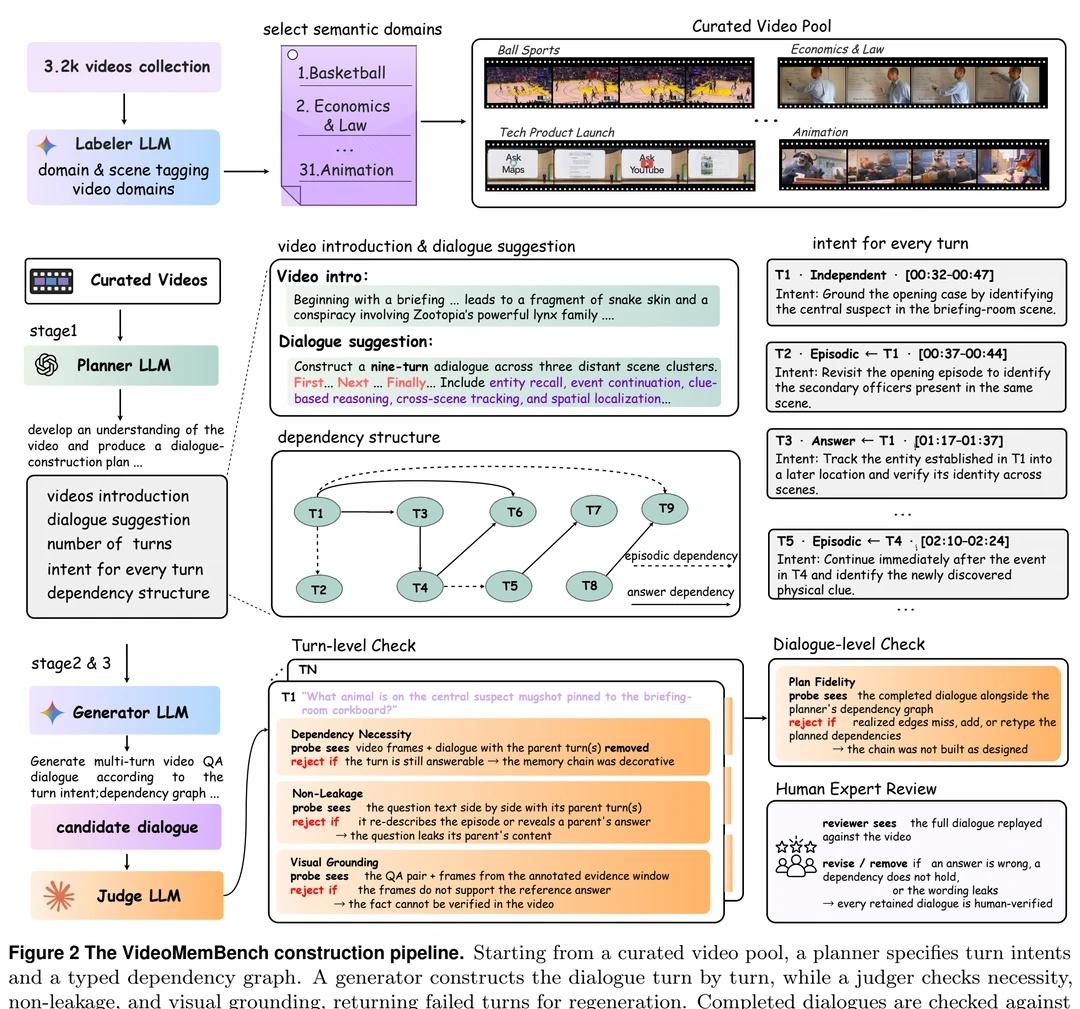
数据集构建思路也很有参考性:
用Planner+Generator+Judge三个LLM角色流水线造数据,还要人工复核,保证问题不能脱离前文、不能直接从当前画面得出答案。
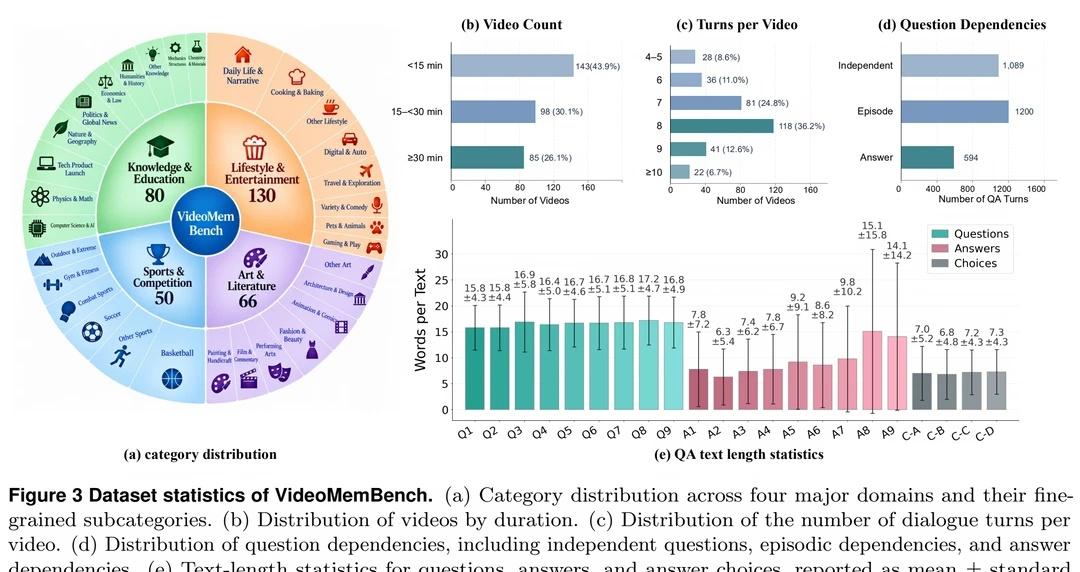
一共326段视频、2476轮对话,覆盖影视、运动、经济等很多场景
评测结果很扎心:
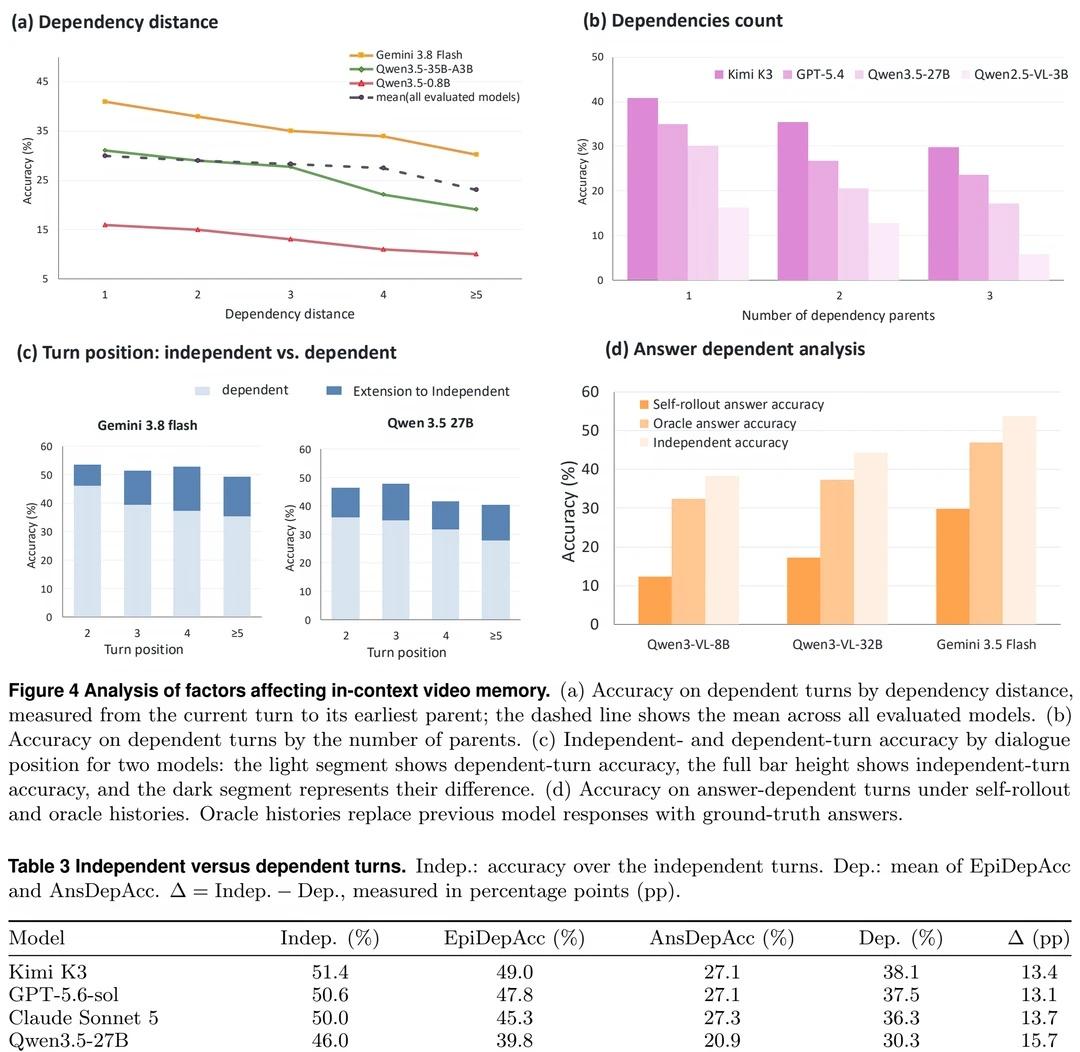
哪怕是Claude Opus5,在答案依赖这种链式任务上得分也只有35.7%
一个规律很明显:
需要回溯的历史轮次越远、要关联的前置信息越多,模型准确率掉得越厉害
而且前面回答一旦出错,整条推理链后面全部崩盘,这也是视频Agent落地很难的关键点
我的理解总结:
现在大家卷视频理解,大多聚焦帧识别、画面检测;
但「时序记忆+对话链路追溯」是一个很容易被忽略的方向
想要做能和人持续聊视频的Agent,不只是看懂单帧,更要学会把跨轮次的信息存住、串联检索
这个benchmark给我们提供了一套现成的评测范式,想做视频Agent、MLLM时序记忆方向的可以参考这个框架