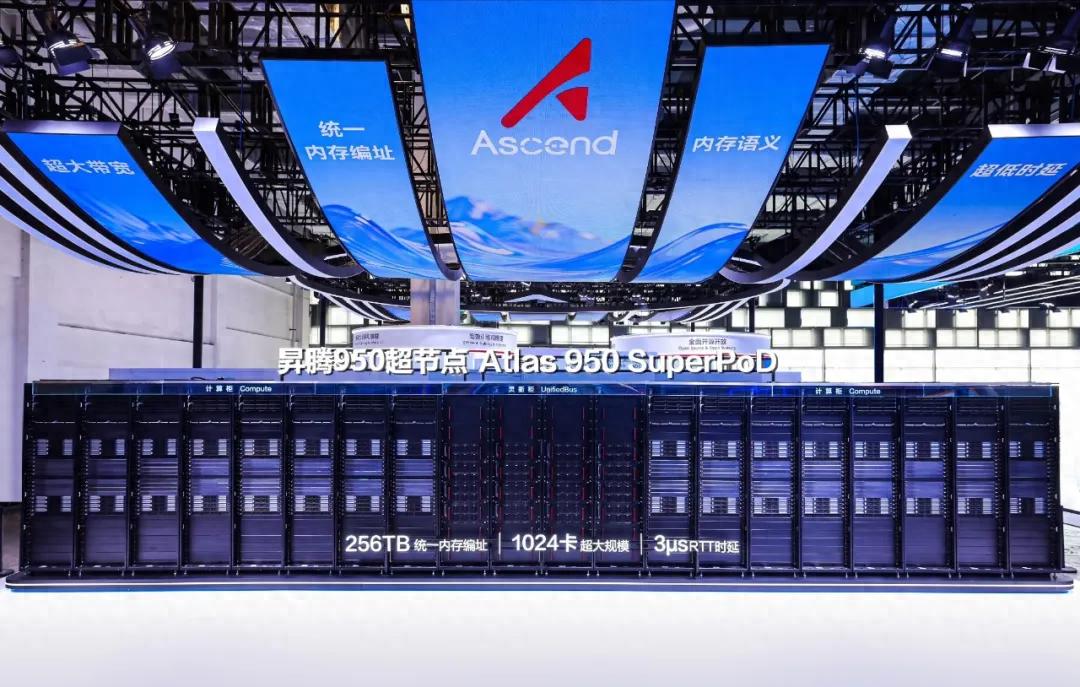
8月1日这天,AI 算力圈像约好了似的集中放料。华为在深圳坂田宣布昇腾 950 一次性流片成功,单卡 FP16 算力 1.6 PFLOPS,号称国产芯首次正面比肩英伟达 H200;几乎同一时段,澜起科技试产 CXL 3.2 内存扩展控制器,中国开源模型累计下载量被曝突破 100 亿次、全球占比 41% 登顶。
单看任何一条,都是振奋的消息。但把它们摆在一起,一个更值得追问的问题就冒出来了:中国 AI 算力,是真的到了"好用"的拐点,还是又一次让人上头的突破叙事?
我倾向前者,但要加一句限定——脚已经迈过去了,路还长。
一条产业链上的几声捷报
这几条消息看着热闹,但各自卡在产业链的哪一环,得先理一理,否则容易把"进展"和"胜利"混为一谈。
AI 算力从来不是一颗芯片的事。一台能跑大模型的服务器,至少由三块咬合而成:负责海量矩阵运算的加速卡(GPU/NPU)、负责通用调度的中央处理器(CPU)、以及把成百上千张卡连成集群的高速网络与内存。
过去十年,英伟达靠"GPU + CUDA 生态"吃下了大头,靠的从来不是单卡跑分,而是一整套说法统一、开箱即用的体系。
华为这次发布的昇腾 950,定位就是那颗"加速卡"。据发布会披露,它采用中芯国际 N+2 工艺(等效 5nm),集成 1080 亿晶体管,搭载自研达芬奇 3.0 架构与 HBM3e 高带宽内存(96GB、带宽 4.6TB/s),并首次集成"星脉"光互连模块,支持 8 卡全互连、单柜算力 12.8 PFLOPS。
在 Llama-3 405B 训练测试中,集群性能较前代提升 2.7 倍。阿里云、腾讯云、百度智能云都已宣布上线昇腾 950 实例。
同一天的另一条线在"内存"侧。澜起科技试产 CXL 3.2 内存扩展控制器,最高支持 64 GT/s、双 DDR5 兼容 8000 MT/s,已导入三星、SK 海力士下一代产品体系。它的价值在于:当单颗芯片算力够用、却被内存卡住脖子时,CXL 能把内存"池化",突破物理上限——这恰好是 AI 训练推理里最烧钱的那道"内存墙"。

拐点是真的,胜利还没到
把这些碎片拼起来,我自己的判断是——2026 年,中国 AI 算力正从"单点可用"走向"全栈协同",这是个确定性趋势,但远没到能宣布胜利的时候。
说"确定性",是因为今天的捷报不再是某一家公司的孤军奋战,而是"芯片—内存—封装—模型—云"多个环节同频共振。开源模型下载破 100 亿次、前六大模型全部来自中国团队,意味着上层应用已经愿意跑在国产底座上。
说"不能宣布胜利",是因为两道硬坎还在:一是生态,二是制程。昇腾 950 兼容 PyTorch、MindSpore、vLLM、SGLang 并给出 CANN 7.0 工具链,跨出关键一步,但 CUDA 沉淀了十余年的开发者习惯、库与调优经验,不是靠兼容层就能抹平的。
制程上 N+2(等效 5nm)固然可用,而台积电、英特尔已在更先进节点领跑,且光刻机这道闸门仍握在别人手里。把"流片成功"直接等同于"全面超越",是把里程碑当成了终点线。

几个数字能说明问题
先看算力侧。昇腾 950 的 1.6 PFLOPS(FP16)是官方披露峰值,与英伟达 H200 处于同一量级——这是国产加速卡第一次在纸面峰值上"平视"对手,意义不小,但纸面峰值不等于真实体验,中间还隔着软件、集群调度和一整套工程化能力。
再看规模侧。中国开源模型累计下载量破 100 亿次、占全球 41%,过去 12 个月有 9 个月保持全球开源模型规模上限——"有人用"已经不是问题,"好不好用"成了新战场。

把英伟达的动作摆进来才看得清
光看自己人报喜,容易自我感动。把英伟达同一天的动作对照着看,反而更清醒。
8 月 1 日,英伟达 Vera CPU 正式量产交付,标志着它完成"CPU+GPU+网络"三位一体的垂直整合。黄仁勋的打法,是从"卖铲子"升级成"建整座矿山"——云厂商买回去接上电就能转。
这套打法提醒我们:算力的竞争早已不是"谁的单卡更快",而是"谁能定义整套数据中心的架构"。中国厂商今天在单点上追上来,下一步要补的,正是把芯片、网络、软件打包成"开箱即用方案"的系统能力。
横向比美国,纵向比五年前
横向看,美国走"垂直闭环"路线,一家公司对标一整条产业链;中国走"全栈协同"路线,靠多家企业分别补齐环节、再靠开源生态串联。两条路没有绝对优劣,只是风险结构不同。
纵向看,五年前我们还在为"有没有"发愁,今天已经在讨论"好不好用"。这个位移本身,就是最扎实的进步。
也别只听好消息
不过,好消息之外,有几道坎得正视。英伟达 Vera 代表的垂直整合,正在为下一代 AI 数据中心立一套新标准,国产在"系统定义权"上仍被动。
玻璃基板虽是中国制造的优势腹地,但核心材料、关键设备与良率工艺仍部分受制于人。制程端,N+2 与最先进节点之间还有代差,上游设备约束短期难解。
更值得警惕的是叙事本身。每逢"流片成功""性能比肩",舆论就容易滑向两个极端:要么妄自菲薄,要么盲目自大。理性的态度是:为每一次真实进步鼓掌,同时盯着那几道还没跨过的坎。

往后看,三件事会越来越清楚
第一,算力竞争进入"系统战"。谁能把芯片、内存、网络、软件、能耗拧成一套高效系统,谁就掌握主动权。
第二,开源模型与国产硬件会加速"互相成就"。模型下载全球第一,意味着需求侧已经就位;硬件补到位,供需闭环就转起来了。
第三,封装与互连会成为新主战场。"玻璃基板""光互连""CXL 内存池化"这些冷门词,会决定下一代芯片的性能天花板。

说回普通人
AI 算力听着很远,但它最终会落到三件具体的事上:你用的软件是否更聪明、你所在的行业是否被重新定义、你或你家孩子能不能赶上这一波产业机会。
今天这一连串捷报,至少是颗定心丸——我们在最被"卡脖子"的地方,正一寸一寸把路走通。但定心丸不等于安眠药。真正的强大,不是某天突然宣布领先,而是日复一日把生态、制造、应用这三件事同时做扎实。
你怎么看中国 AI 算力的这一步?欢迎在评论区聊聊你的观察。