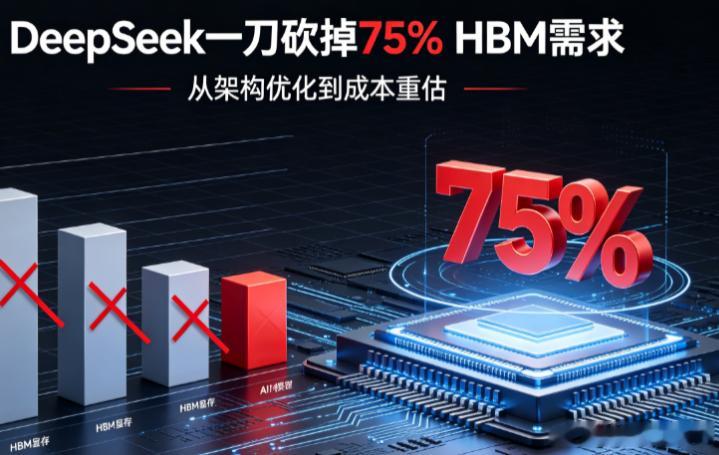
DeepSeek一刀砍掉75% HBM需求
DeepSeek于9月10日发布的V4.1-Flash模型,通过架构创新将KV Cache(键值缓存)的HBM高带宽内存需求降至上一代的25%,即降低了75%;
同时,其SSD存储需求也大幅缩减至上一代的12.5%,降幅高达87.5%。这一优化显著降低了AI推理的硬件成本,并引发了市场对存储芯片需求前景的重新评估。
KV Cache的极限压缩此次降本的核心在于对KV Cache的优化。在AI推理中,KV Cache用于存储注意力状态,其大小随对话长度增长,是推理阶段内存消耗的主要来源。
主缓存FP4量化:将主KV缓存的数据格式改为FP4(4位浮点数),在精度损失可控的前提下大幅降低存储需求。
跨层复用:采用跨层复用技术,让不同Transformer层共享缓存信息,避免重复存储。
效果:每个Token的全局KV缓存最终仅需890字节,约为V4-Flash的1/4;长期存储于SSD或内存中的缓存进一步降至约1/8。
尽管模型规模扩大(主干参数从V4-Flash的2820亿增至5520亿),但V4.1-Flash通过Causal-Encoder-Decoder(CED)新架构和Engram条件记忆(1960亿参数)实现了效率的飞跃。
维度 推理速度 V4.1-Flash 表现500-600 Token/s 对比上一代为V4-Flash的3-4倍
HBM需求 V4.1-Flash 表现降至1/4 对比上一代降低75%
SSD需求 V4.1-Flash 表现降至1/8 对比上一代降低87.5%
API缓存命中价格 V4.1-Flash 表现下跌对比上一代60% 综合使用成本减半
对存储芯片市场的即时冲击新模型发布后,市场迅速反应,SK海力士股价下跌5.2%,美光科技下跌4.9%,费城半导体指数跌超2%。投资者担忧,AI模型效率的跃升可能削弱由“算力军备竞赛”驱动的存储芯片需求。
需求影响的范围界定需要明确的是,75%的降幅仅针对KV Cache部分。DeepSeek并未声称整个模型或数据中心的总HBM用量减少75%。用于存储模型权重和训练过程的内存需求并未被此次优化覆盖。人工智能DeepSeek储存芯片半导体科技 深圳竟业电子IC芯片供应商