DC娱乐网

迈凌漫说科技的文章

「AI」用GPT-6 Astra Ultra模型还是很过瘾的。甭管多复杂,一两个小时就能很好的完成任务。美中不足就是,这种推理强度玩不了多久。上个星期,全天用Ultra还能潇洒一天,现在我怀疑只够十几小时了。这是架构任务我才用的,后续真不想这么玩了。 ​
「AI」用GPT-6 Astra Ultra模型还是很过瘾的。甭管多复杂,一两个小时就能很好的完成任务。美中不足就是,这种推理强度玩不了多久。上个星期,全天用Ultra还能潇洒一天,现在我怀疑只够十几小时了。这是架构任务我才用的,后续真不想这么玩了。 ​
「AI」用GPT-6 Astra Ultra模型还是很过瘾的。甭管多复杂,一两个小时就能很好的完成任务。美中不足就是,这种推理强度玩不了多久。上个星期,全天用Ultra还能潇洒一天,现在我怀疑只够十几小时了。这是架构任务我才用的,后续真不想这么玩了。 ​
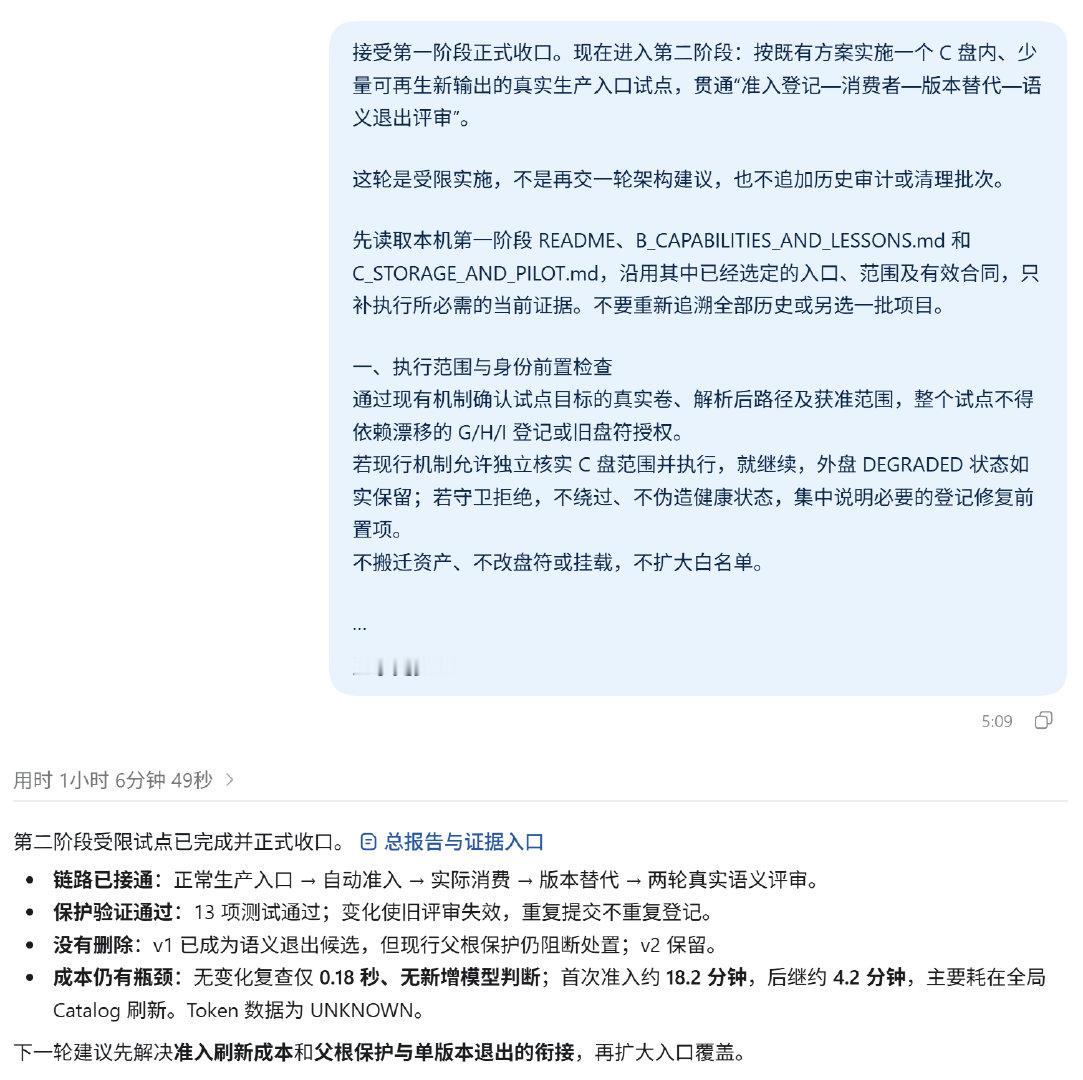
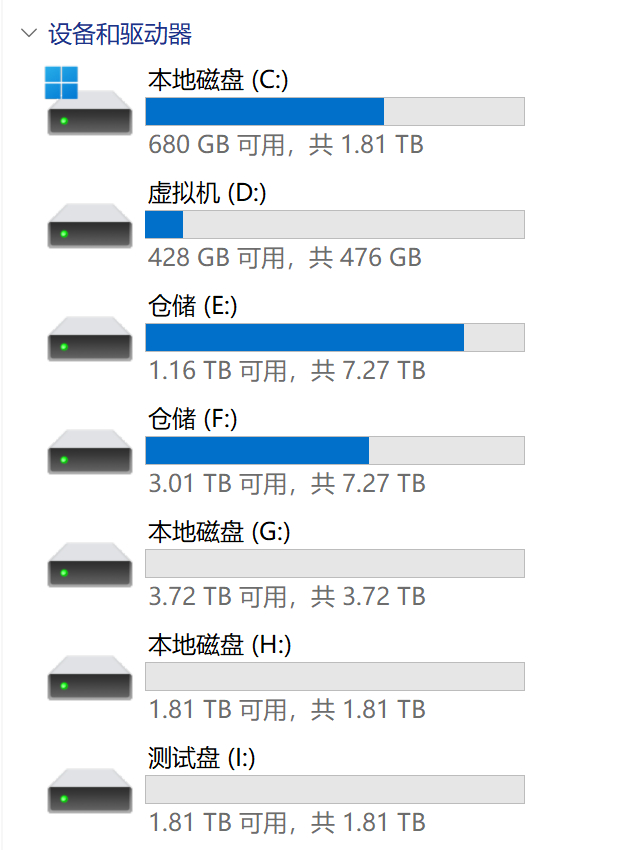
「AI」我一开始想用一次彻底的全盘清理,迭代出后续智能清理系统的框架,再把这种框架结合所有盘符现状,重新设计整个主机的文件结构与规则。但没想到第一步的全盘清理就走了两星期,我能找到的两个会话就消耗了21亿token,还有几个会话因为没有及时重命名,正在找。

一共只清理出去180G的文件。token ​

「AI」我一开始想用一次彻底的全盘清理,迭代出后续智能清理系统的框架,再把这种框架结合所有盘符现状,重新设计整个主机的文件结构与规则。但没想到第一步的全盘清理就走了两星期,我能找到的两个会话就消耗了21亿token,还有几个会话因为没有及时重命名,正在找。 一共只清理出去180G的文件。token ​

「AI」我一开始想用一次彻底的全盘清理,迭代出后续智能清理系统的框架,再把这种框架结合所有盘符现状,重新设计整个主机的文件结构与规则。但没想到第一步的全盘清理就走了两星期,我能找到的两个会话就消耗了21亿token,还有几个会话因为没有及时重命名,正在找。 一共只清理出去180G的文件。token ​

感觉GPT-6 Sol这次被Opus 5.5的性能完全给打懵了,OpenAI全员原地陷入下一轮备战。这会不会给OpenAI一种不好的错觉,即,便宜没那么重要? 它的便宜战略,不是轻易定下来、也不是公开表达的,而是从五月份Codex开始支持其他模型接入的时候,能够被观察到的战略级方向——不再求垄断,而是在价格上也能 ​

感觉GPT-6 Sol这次被Opus 5.5的性能完全给打懵了,OpenAI全员原地陷入下一轮备战。这会不会给OpenAI一种不好的错觉,即,便宜没那么重要? 它的便宜战略,不是轻易定下来、也不是公开表达的,而是从五月份Codex开始支持其他模型接入的时候,能够被观察到的战略级方向——不再求垄断,而是在价格上也能 ​

「AI」基本上没有多少歧义,今天的巨头大战以Opus 5.5的胜利而告终,至少在各种测试中和声量中都是这样。或许本身Anthropic的用量并不让人感到紧张,大家都对价格非常不敏感,都想要最好的智能。 Dario说要大家慢下来,人家奥特曼和马斯克都同意了,现在他一甩手就又重回巅峰。这人嘴里也没实话啊。说 ​

「AI」基本上没有多少歧义,今天的巨头大战以Opus 5.5的胜利而告终,至少在各种测试中和声量中都是这样。或许本身Anthropic的用量并不让人感到紧张,大家都对价格非常不敏感,都想要最好的智能。 Dario说要大家慢下来,人家奥特曼和马斯克都同意了,现在他一甩手就又重回巅峰。这人嘴里也没实话啊。说 ​

OpenAI今年是靠GPT 5.5翻盘的,现在Anthropic出了Opus 5.5;2023年,OpenAI是靠GPT 4拿下全球市场的,接下来这段时间,角落里的Google要发Gemini 4,而开源的Qwen 4也要来。命名上其实是“有点说法”的。 ​

OpenAI今年是靠GPT 5.5翻盘的,现在Anthropic出了Opus 5.5;2023年,OpenAI是靠GPT 4拿下全球市场的,接下来这段时间,角落里的Google要发Gemini 4,而开源的Qwen 4也要来。命名上其实是“有点说法”的。 ​

「AI」我开了两个会话,一个是GPT-6 Sol xHigh,一个是GPT-6 Sol High,跑了1.2小时,掉了2%周额度。这个效能比Astra有进步,但是不多。因为两个会话已经很少了,一周168小时,有效运行时长也就60小时。数据量不够。跑完今天全天,明天我测试Luna怎么样。我要找到token和性能都够用的平衡点。 ​

「AI」我开了两个会话,一个是GPT-6 Sol xHigh,一个是GPT-6 Sol High,跑了1.2小时,掉了2%周额度。这个效能比Astra有进步,但是不多。因为两个会话已经很少了,一周168小时,有效运行时长也就60小时。数据量不够。跑完今天全天,明天我测试Luna怎么样。我要找到token和性能都够用的平衡点。 ​
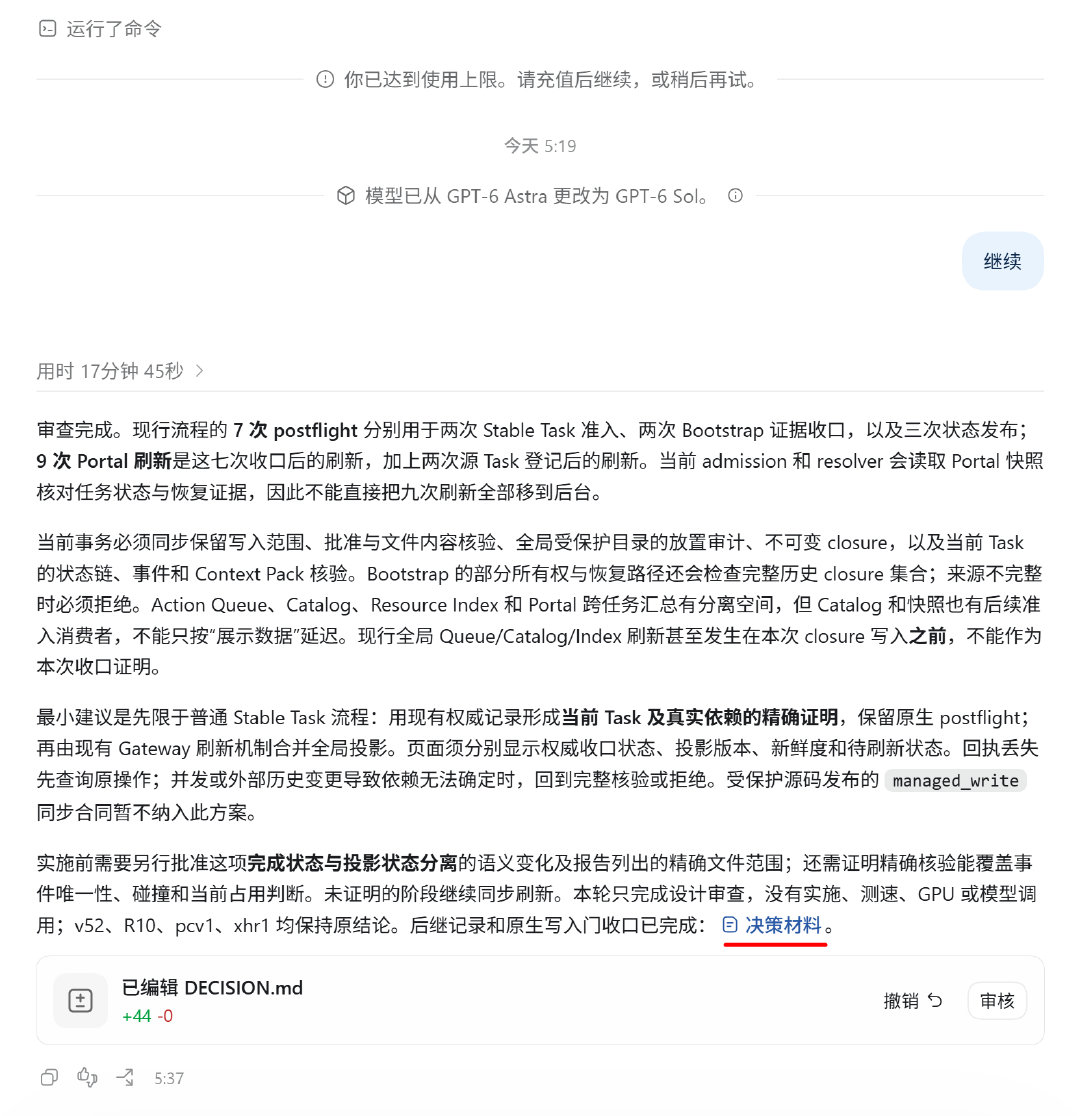
「AI」我用GPT-6 Sol xHigh继续之前令我艰难苦痛的任务,它的风格和Astra有明显的差异。不再是写大段的不同格式的文档,而是直接形成“决策材料”。它知道我需要的是进一步决策,而不是需要多份文档来证明它上一步做得不错。GPT-6 PRO对Sol模型的评价是还行。显然这是后训练。节省80%的token很重要。 ​

「AI」我用GPT-6 Sol xHigh继续之前令我艰难苦痛的任务,它的风格和Astra有明显的差异。不再是写大段的不同格式的文档,而是直接形成“决策材料”。它知道我需要的是进一步决策,而不是需要多份文档来证明它上一步做得不错。GPT-6 PRO对Sol模型的评价是还行。显然这是后训练。节省80%的token很重要。 ​

「AI」我用GPT-6 Sol xHigh继续之前令我艰难苦痛的任务,它的风格和Astra有明显的差异。不再是写大段的不同格式的文档,而是直接形成“决策材料”。它知道我需要的是进一步决策,而不是需要多份文档来证明它上一步做得不错。GPT-6 PRO对Sol模型的评价是还行。显然这是后训练。节省80%的token很重要。 ​

老中用开源模型的价格去打老美的模型,OpenAI用自己的价格去打Anthropic.所以不要怪人家Dario一天天的苦大仇深,他幻想中的模型垄断、自己一家拿到30万亿美元的估值不仅没有到来,而且他还是整个链条被坑得最惨的。白花花的智能,就这么下放给穷人,造孽啊。Dario常常如此感叹。 ​

老中用开源模型的价格去打老美的模型,OpenAI用自己的价格去打Anthropic.所以不要怪人家Dario一天天的苦大仇深,他幻想中的模型垄断、自己一家拿到30万亿美元的估值不仅没有到来,而且他还是整个链条被坑得最惨的。白花花的智能,就这么下放给穷人,造孽啊。Dario常常如此感叹。 ​

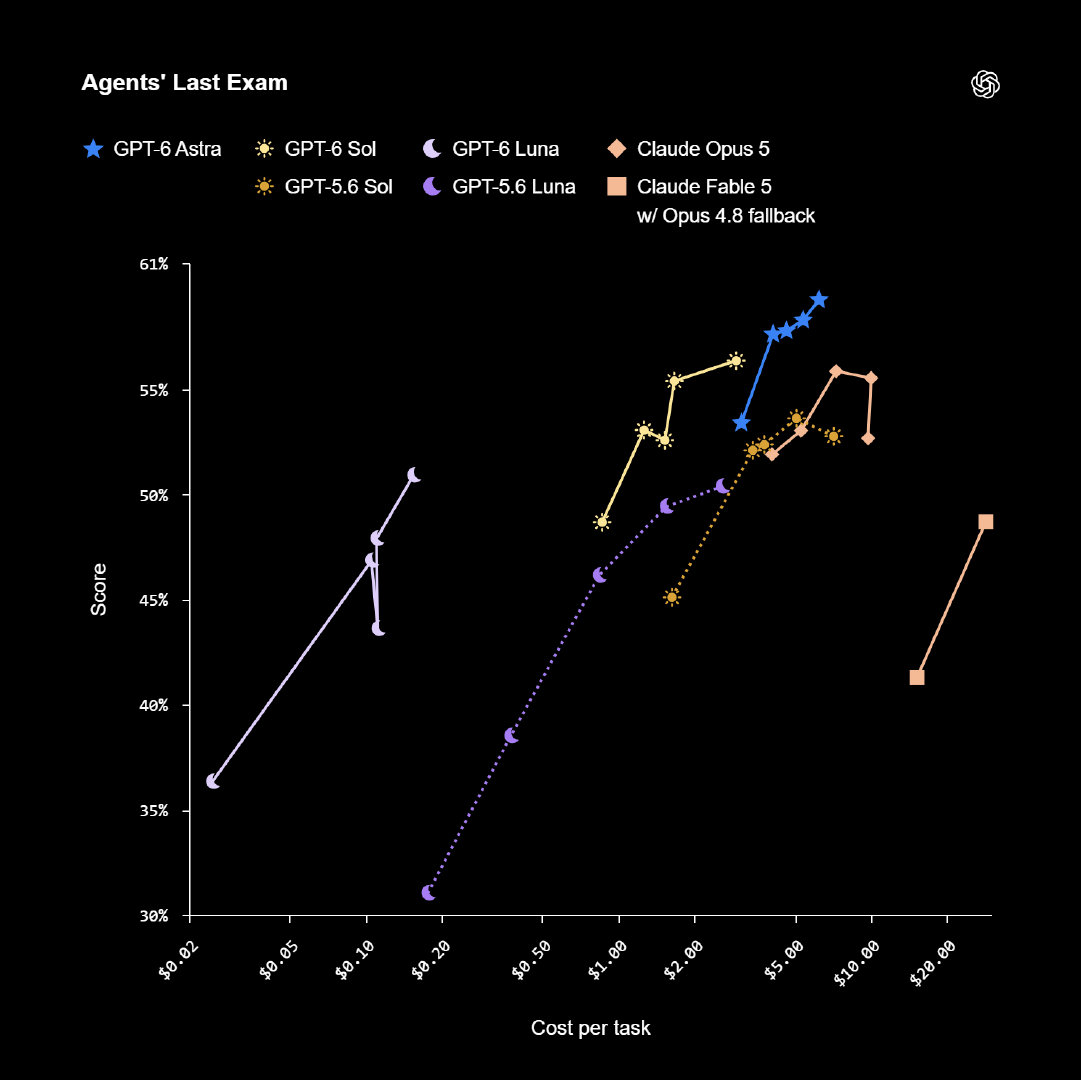
其实目前绝大部分用到AI的场景,GPT-6 Luna就能够胜任,Sol就已经过剩。它们的性能已经追平甚至超过了Anthropic的旗舰模型,但成本降低了九成。如果很多人只是做做文档,PPT,或者写一些小程序,Luna就过剩了。有一种例外的场景,就是你在写地球上没还有存在过的东西。那时候Astra都扛不住。 ​

其实目前绝大部分用到AI的场景,GPT-6 Luna就能够胜任,Sol就已经过剩。它们的性能已经追平甚至超过了Anthropic的旗舰模型,但成本降低了九成。如果很多人只是做做文档,PPT,或者写一些小程序,Luna就过剩了。有一种例外的场景,就是你在写地球上没还有存在过的东西。那时候Astra都扛不住。 ​
「AI」GPT-6 Sol和GPT-6 Luna都发布了,最亮眼的是它的价格。相对于Astra,Sol的价格便宜了5倍,Luna的价格便宜了100倍。如果按照此前我推算的PRO*20的订阅,Astra是全球最便宜的模型,那么Luna就是比最便宜的还要便宜100倍。这个团队还是非常狠的,不留死角的武装自己。 ​

「AI」GPT-6 Sol和GPT-6 Luna都发布了,最亮眼的是它的价格。相对于Astra,Sol的价格便宜了5倍,Luna的价格便宜了100倍。如果按照此前我推算的PRO*20的订阅,Astra是全球最便宜的模型,那么Luna就是比最便宜的还要便宜100倍。这个团队还是非常狠的,不留死角的武装自己。 ​

「AI」GPT-6 Sol和GPT-6 Luna都发布了,最亮眼的是它的价格。相对于Astra,Sol的价格便宜了5倍,Luna的价格便宜了100倍。如果按照此前我推算的PRO*20的订阅,Astra是全球最便宜的模型,那么Luna就是比最便宜的还要便宜100倍。这个团队还是非常狠的,不留死角的武装自己。 ​

「坑」明目张胆偷用户数据的AI,浮出水面的越来越多,都是打包上传,把用户的电脑当

「坑」明目张胆偷用户数据的AI,浮出水面的越来越多,都是打包上传,把用户的电脑当

几个月前Tibo说,以后Agent并发会在云上,因为对电脑的要求很高。这很有道理。都去买几万的设备很不现实。厂家买反而更便宜,个人也少受点AI溢价的盘剥。Codex Bot是必然来的。惊喜会在于,目前OpenAI有着最强的产品力。其实它真正翻盘也就始于5月份的Codex,从100万用户到几千万。 ​

几个月前Tibo说,以后Agent并发会在云上,因为对电脑的要求很高。这很有道理。都去买几万的设备很不现实。厂家买反而更便宜,个人也少受点AI溢价的盘剥。Codex Bot是必然来的。惊喜会在于,目前OpenAI有着最强的产品力。其实它真正翻盘也就始于5月份的Codex,从100万用户到几千万。 ​
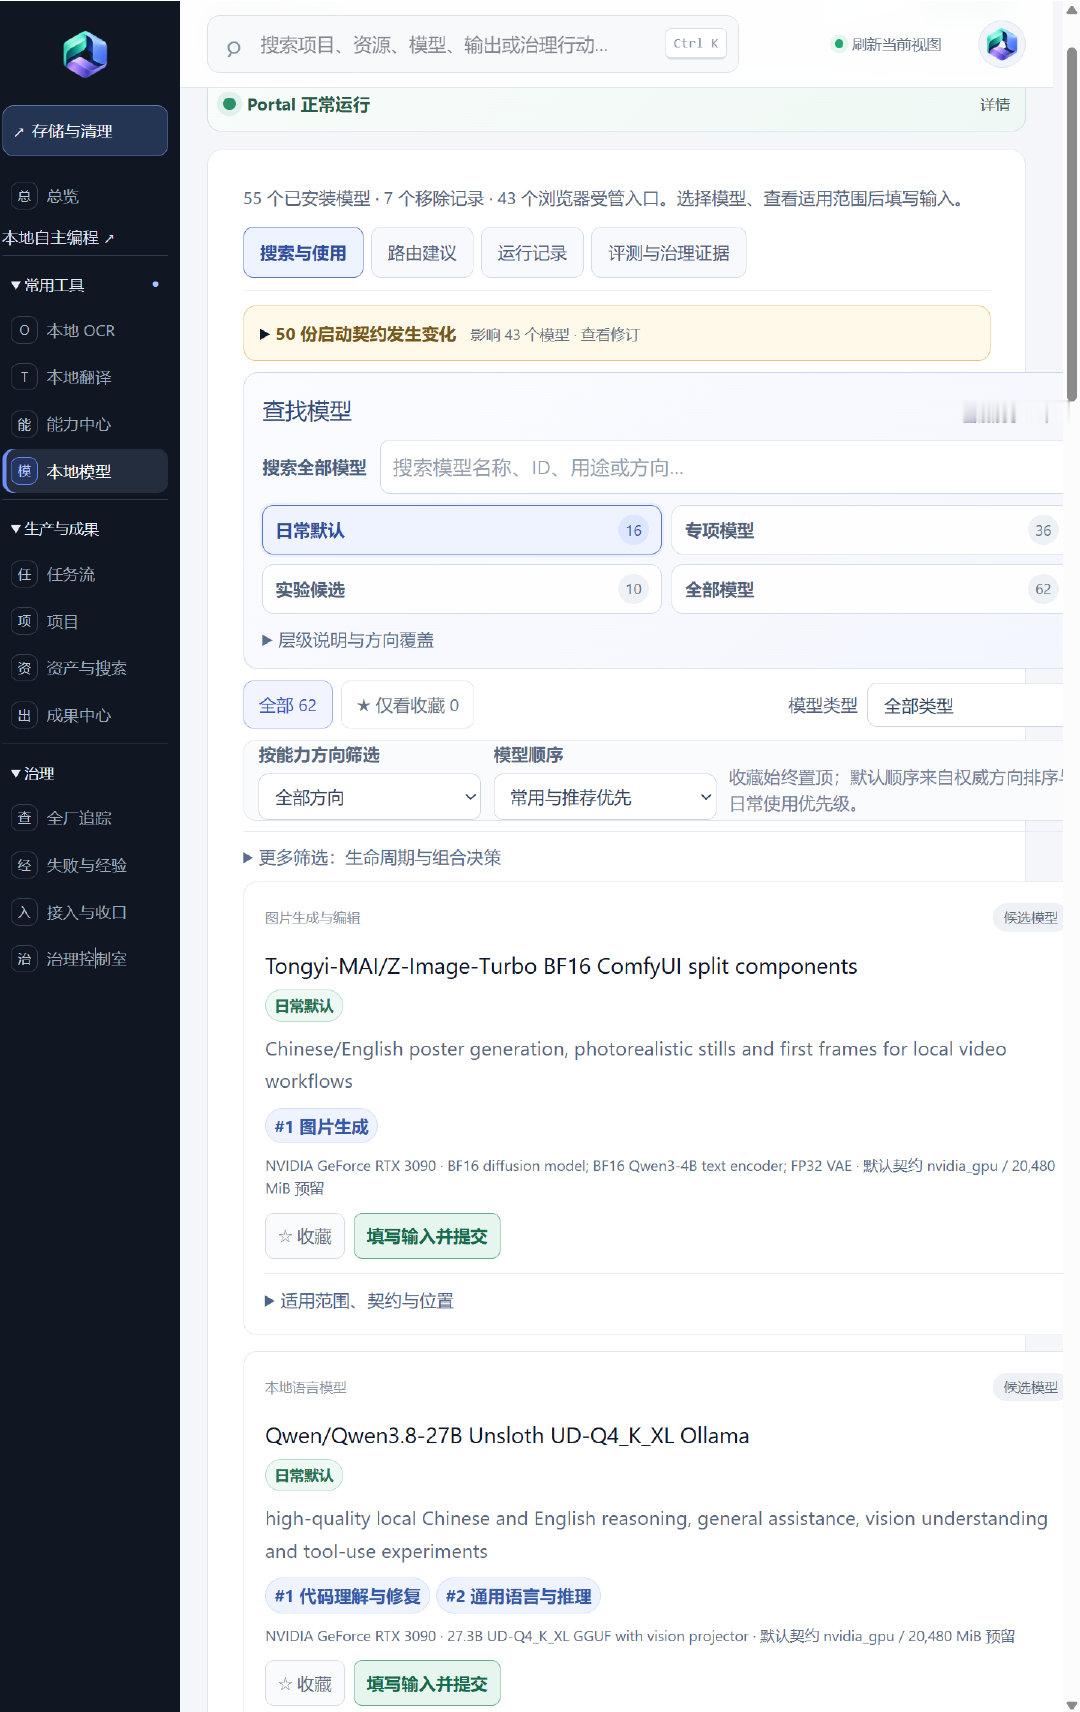
「AI」把所有的本地模型集中在同一个入口,是我最早做的一件事。这件事看起来容易,但因为涉及到几十种不同模型和依赖,无异于写个大型的编辑器。在5.6 Sol的阶段,AI还没有能力做好这件事。直到Astra的时候,一条过。我现在把所有功能都往浏览器上堆,背后都有复杂的后端。这只有许愿式的AI能办到。 ​

「AI」把所有的本地模型集中在同一个入口,是我最早做的一件事。这件事看起来容易,但因为涉及到几十种不同模型和依赖,无异于写个大型的编辑器。在5.6 Sol的阶段,AI还没有能力做好这件事。直到Astra的时候,一条过。我现在把所有功能都往浏览器上堆,背后都有复杂的后端。这只有许愿式的AI能办到。 ​

「AI」把所有的本地模型集中在同一个入口,是我最早做的一件事。这件事看起来容易,但因为涉及到几十种不同模型和依赖,无异于写个大型的编辑器。在5.6 Sol的阶段,AI还没有能力做好这件事。直到Astra的时候,一条过。我现在把所有功能都往浏览器上堆,背后都有复杂的后端。这只有许愿式的AI能办到。 ​

Tibo再次承诺周二会重置,距离周二仅剩半小时了。我已经摩拳擦掌、急不可耐了,也不想等了。试着打开Codex,发现打开不了。应该是Antigravity在工作的时候把底层文件给改坏了。Gemini是很自信的,它什么都敢改。这也正是我不给它完全权限的原因之一。 ​

Tibo再次承诺周二会重置,距离周二仅剩半小时了。我已经摩拳擦掌、急不可耐了,也不想等了。试着打开Codex,发现打开不了。应该是Antigravity在工作的时候把底层文件给改坏了。Gemini是很自信的,它什么都敢改。这也正是我不给它完全权限的原因之一。 ​
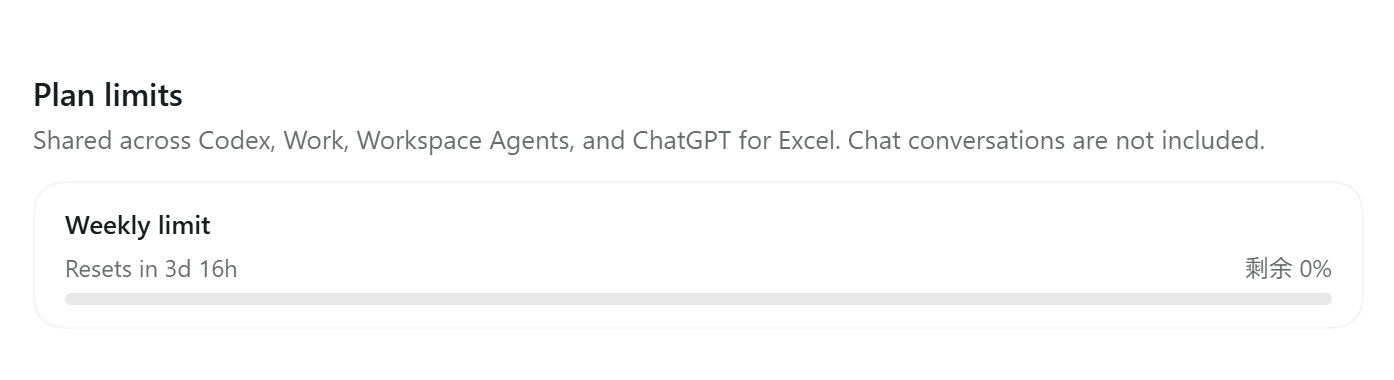
「AI」所有周额度都用光了,还有3天半自然重置。预计在13小时以后,美西周二的凌晨3点,也就是今天的18点,OpenAI要发布一个什么东西。预计在30小时以内,会发一个储蓄重置,如果是这样我不会使用它,必须等3天半以后的自然重置。这周是模型厂商的大乱斗,几大巨头都要发新品。 ​

「AI」所有周额度都用光了,还有3天半自然重置。预计在13小时以后,美西周二的凌晨3点,也就是今天的18点,OpenAI要发布一个什么东西。预计在30小时以内,会发一个储蓄重置,如果是这样我不会使用它,必须等3天半以后的自然重置。这周是模型厂商的大乱斗,几大巨头都要发新品。 ​

「AI」所有周额度都用光了,还有3天半自然重置。预计在13小时以后,美西周二的凌晨3点,也就是今天的18点,OpenAI要发布一个什么东西。预计在30小时以内,会发一个储蓄重置,如果是这样我不会使用它,必须等3天半以后的自然重置。这周是模型厂商的大乱斗,几大巨头都要发新品。 ​

OpenAI发布消息称,TA们的内部模型目前已经解决了数学领域大部分方面超过10

OpenAI发布消息称,TA们的内部模型目前已经解决了数学领域大部分方面超过10

OpenAI发布消息称,TA们的内部模型目前已经解决了数学领域大部分方面超过100个长期存在的未解难题。看起来是一个多星期的算力紧张,拿到了这么多成果。数学真的彻底从王座上掉下来了。 ​

OpenAI发布消息称,TA们的内部模型目前已经解决了数学领域大部分方面超过100个长期存在的未解难题。看起来是一个多星期的算力紧张,拿到了这么多成果。数学真的彻底从王座上掉下来了。 ​

「AI」Jev应该是近年来最成功的模型。虽然被快速逆向,两年成果泡汤,但毕竟是第一个吃螃蟹的。这种只预测和决策的快速路由模型,迅速填补LLM的决策速度的不足。它的玩法正在快速衍生,预计这种能力会被巨头们抄走,进而迸发出更大的效能。最光明正大的做法,应该是收购这个团队。我猜OpenAI会出手。 ​

「AI」Jev应该是近年来最成功的模型。虽然被快速逆向,两年成果泡汤,但毕竟是第一个吃螃蟹的。这种只预测和决策的快速路由模型,迅速填补LLM的决策速度的不足。它的玩法正在快速衍生,预计这种能力会被巨头们抄走,进而迸发出更大的效能。最光明正大的做法,应该是收购这个团队。我猜OpenAI会出手。 ​

前几天,由前OpenAI的创始人员开发两年的Jev路由模型,只做概率预测不生成长文本,很多人惊呼“技术颠覆”,能够大量减少Agent执行时决策的成本。实际上就在当天,我看到有人用GPT-6花了两小时,逆向了这个技术。太残酷了。你带着一帮牛人秘密研发两年,现在的AI两小时逆向。所有产品都可以洗洗睡了。 ​

前几天,由前OpenAI的创始人员开发两年的Jev路由模型,只做概率预测不生成长文本,很多人惊呼“技术颠覆”,能够大量减少Agent执行时决策的成本。实际上就在当天,我看到有人用GPT-6花了两小时,逆向了这个技术。太残酷了。你带着一帮牛人秘密研发两年,现在的AI两小时逆向。所有产品都可以洗洗睡了。 ​

「AI」就在刚刚,人们把Qwen-Image-2.1优化到了4GB显存可以运行,还可以装载无审查版本。这是什么概念啊,4GB啊,我4年前的核显就是4GB啊。势态,是流动的。开源模型正在重新定价全球的计算设备。仅仅几个月前,老中和海外的显卡价格有明显的利差。而今,部分产品的价格已经是美国更高。 我猜这种奇怪 ​

「AI」就在刚刚,人们把Qwen-Image-2.1优化到了4GB显存可以运行,还可以装载无审查版本。这是什么概念啊,4GB啊,我4年前的核显就是4GB啊。势态,是流动的。开源模型正在重新定价全球的计算设备。仅仅几个月前,老中和海外的显卡价格有明显的利差。而今,部分产品的价格已经是美国更高。 我猜这种奇怪 ​