CUDA的护城河,这次又被摆到台面上了。
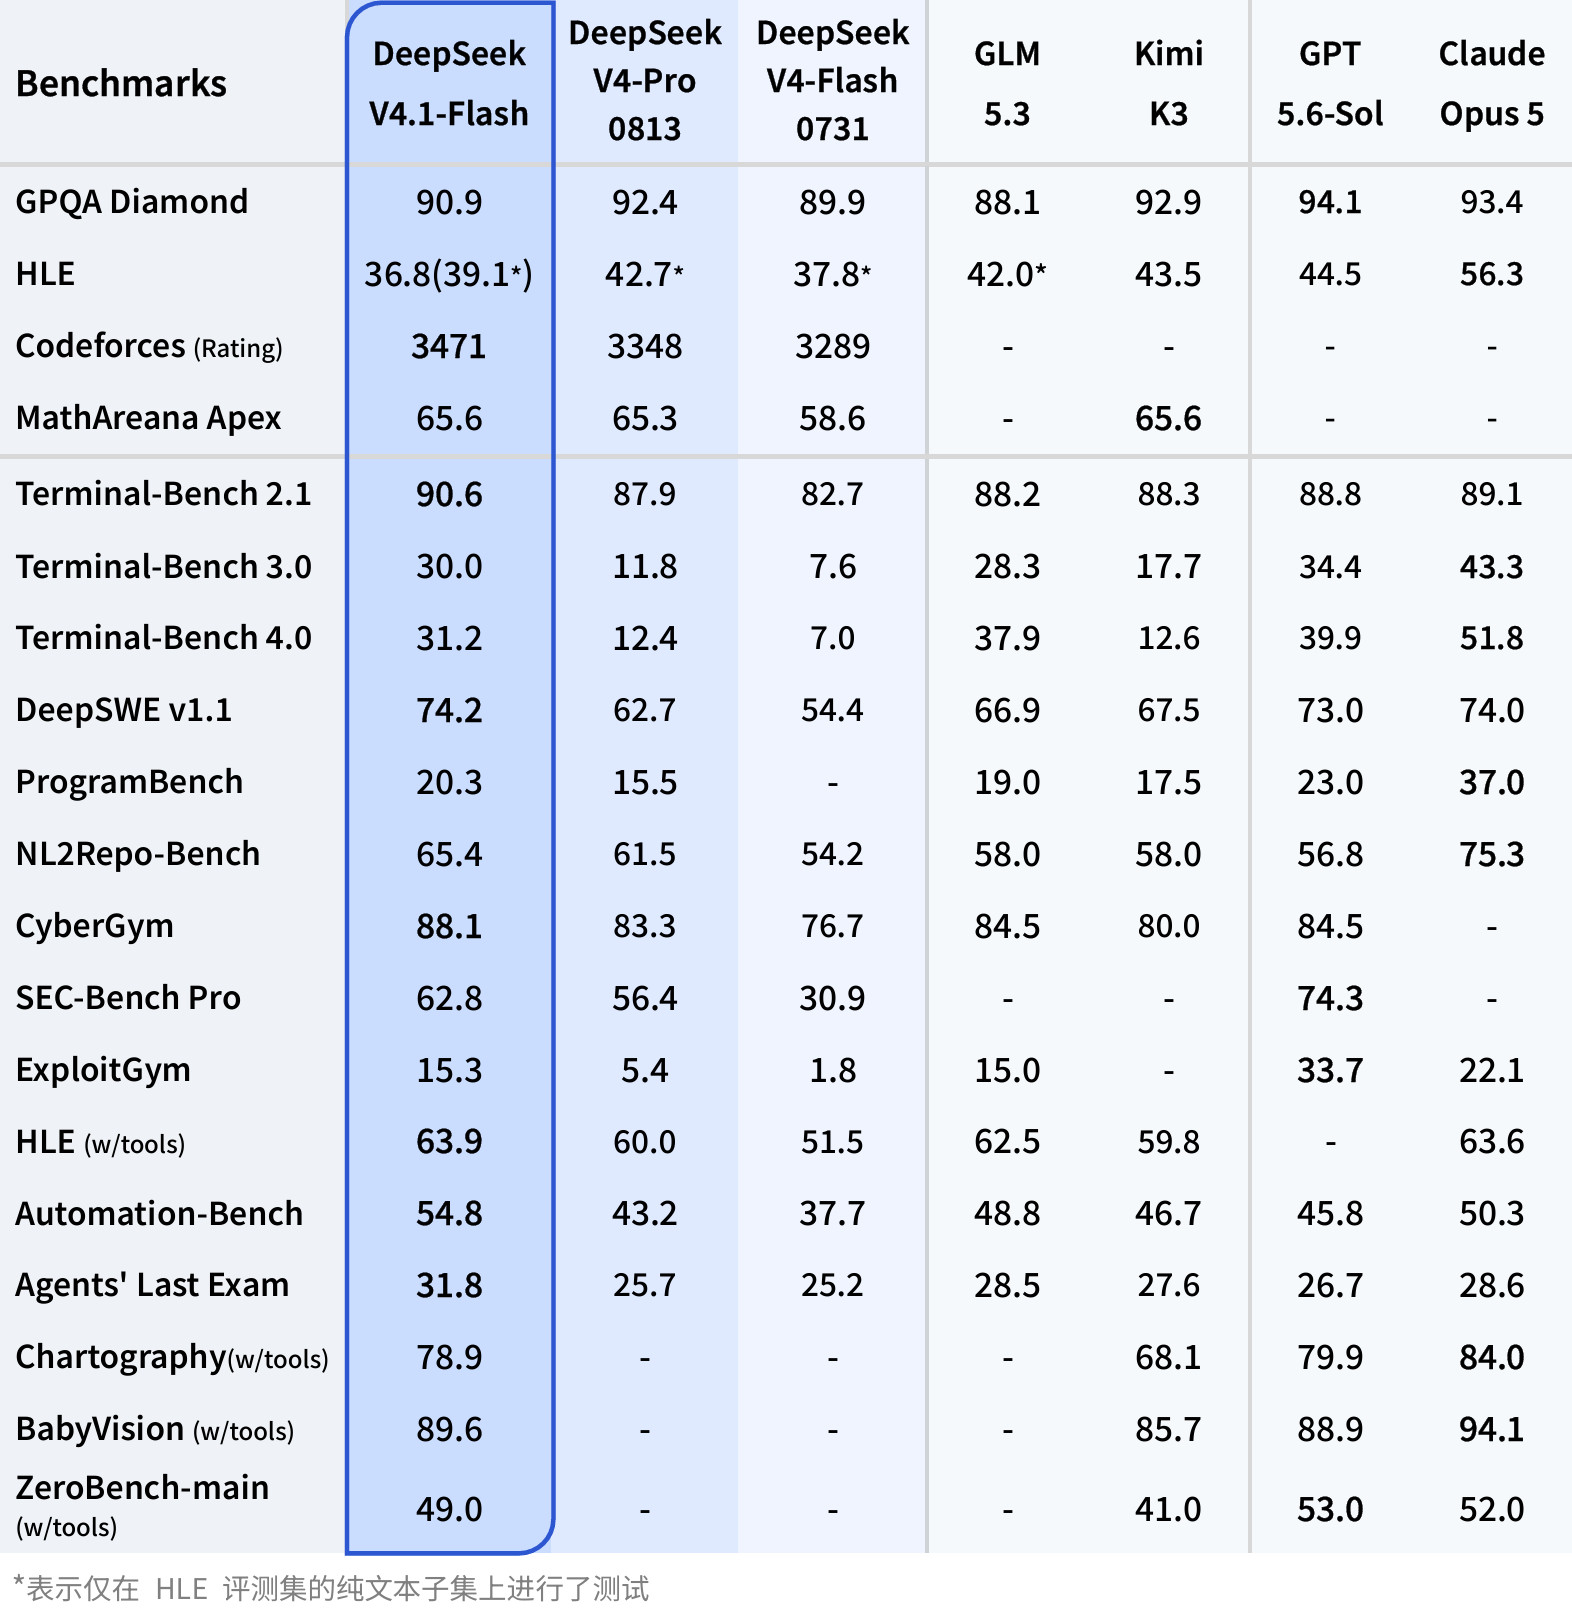
DeepSeek V4.1 Flash发布后,NVIDIA这边的vLLM很快就完成适配,而AMD的对应镜像晚了大约两天才公开。
问题来了:硬件能跑,不代表跑得好。
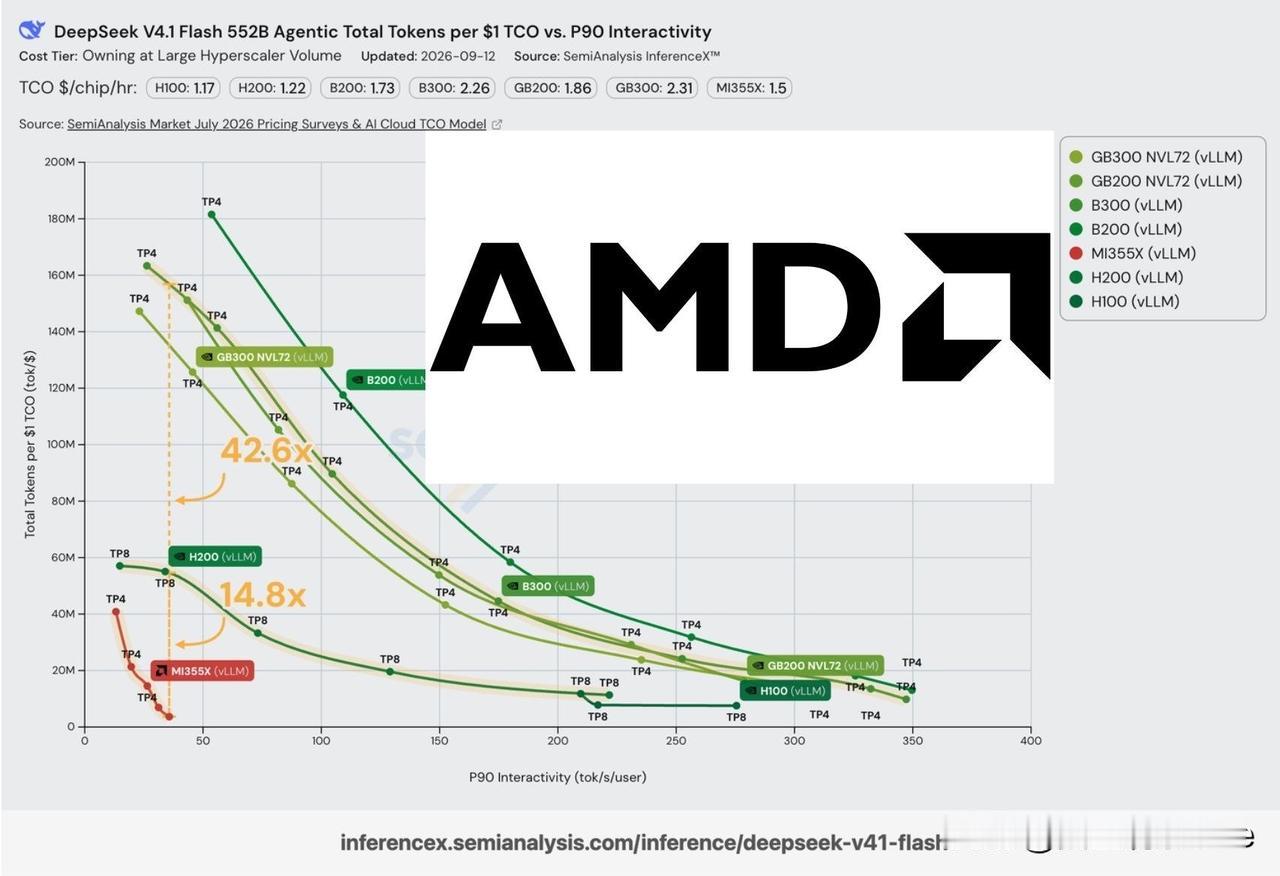
SemiAnalysis测试显示,在当前测试条件下,AMD MI355X跑DeepSeek V4.1 Flash时,按每美元总拥有成本(TCO)计算的性能,最高比H200差14.8倍,与NVIDIA B200/B300相比,差距最高达到42倍。 
这并不意味着AMD的GPU本身差42倍。
真正拉开差距的是软件生态。
DeepSeek V4.1 Flash首发当天,vLLM已经针对NVIDIA多款GPU完成支持,包括H100、H200、B200、B300、GB200和GB300。vLLM目前也已经加入AMD的专门实现,但新模型刚出来时,软件适配速度和优化程度存在明显差距。 
这就是CUDA最难复制的地方。
NVIDIA卖的不只是一块GPU,而是一整套开发工具、框架和开发者生态。模型一更新,大量开发者和软件团队就会围绕CUDA进行优化。
芯片性能可以追,软件生态却不是买几台机器就能补上的。
AMD真正想挑战NVIDIA,可能不是把GPU再做快一点,而是让开发者在新模型发布第一天,就能在AMD平台上获得同样成熟的体验。
你觉得,AI芯片大战最后拼的到底是芯片性能,还是软件生态?