只是优化提示词?WanPE 直接上了 397B
阿里 Wan 团队最近发布了 WanPE 论文,专门研究视频生成前的 Prompt Enhancement。
它做的已经不只是传统意义上的“提示词润色”。
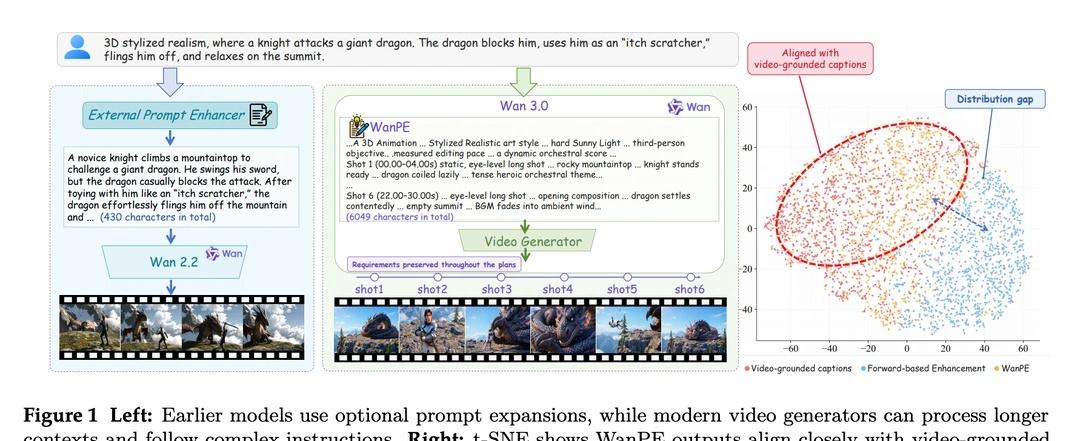
比如用户只写一句:“骑士在山顶挑战巨龙,最后被巨龙甩飞。”
传统 Prompt Enhancer 可能只是补充画风、光线、镜头感。
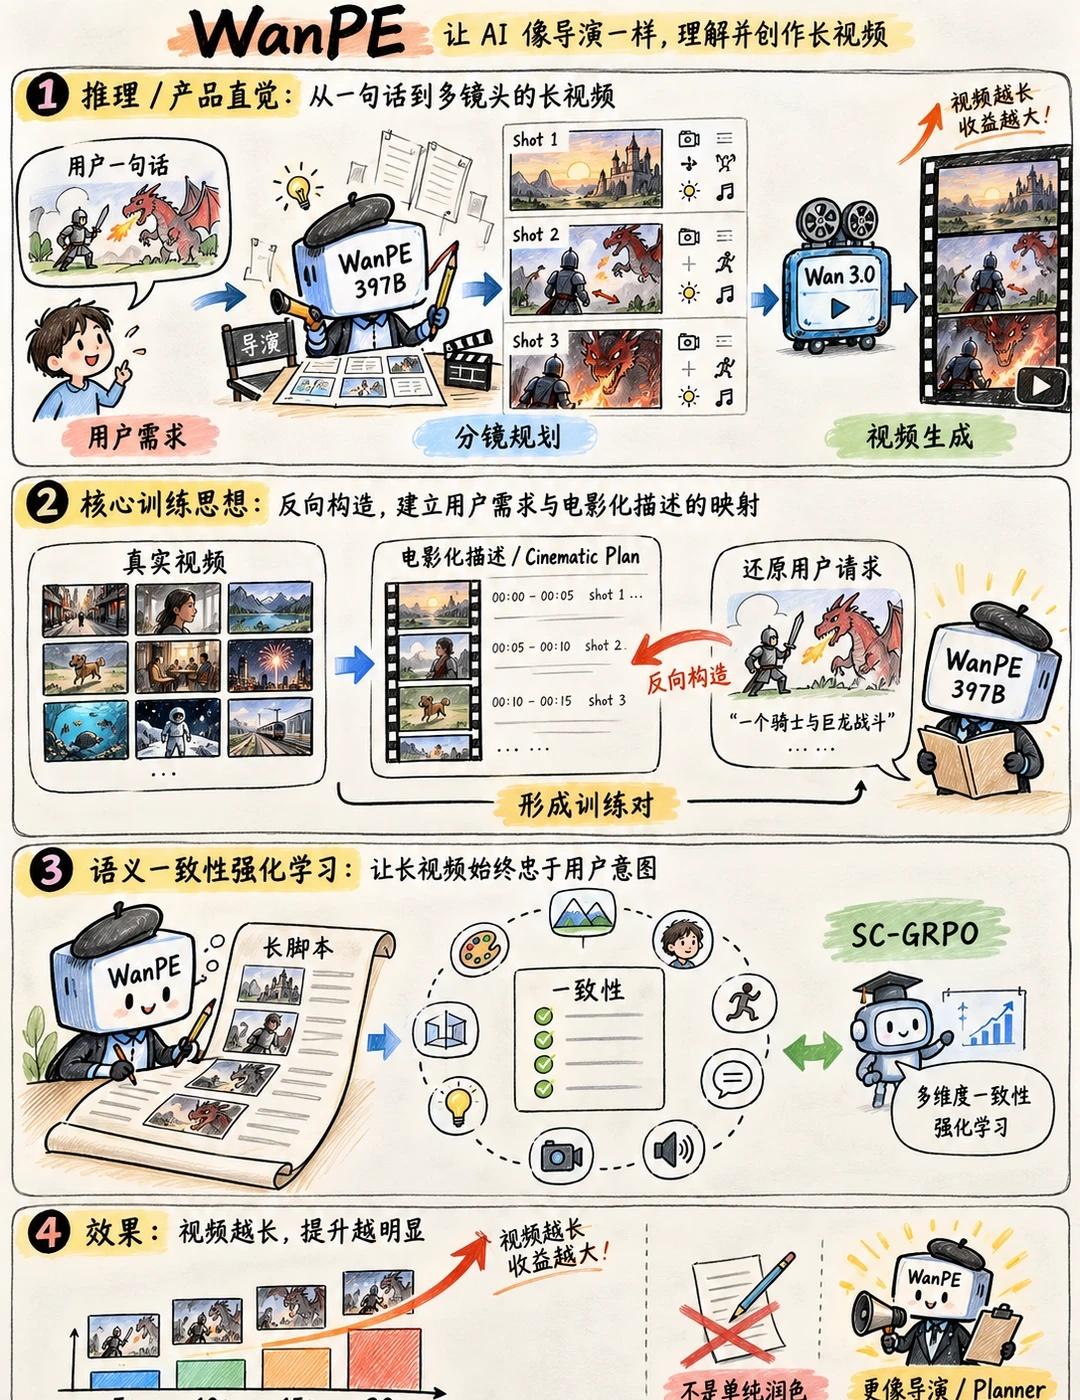
WanPE 会继续往下拆,规划成多个 shot,明确每一段发生什么、镜头怎么拍、灯光怎么变化、音乐和音效怎么配。论文里的例子中,原始请求只有大约 430 个字符,最后会被扩展成 6000 多字符的完整视频规划。
它比较特别的一点,是训练数据的构造方式。
传统做法通常是:用户 Prompt → LLM 扩写 Prompt
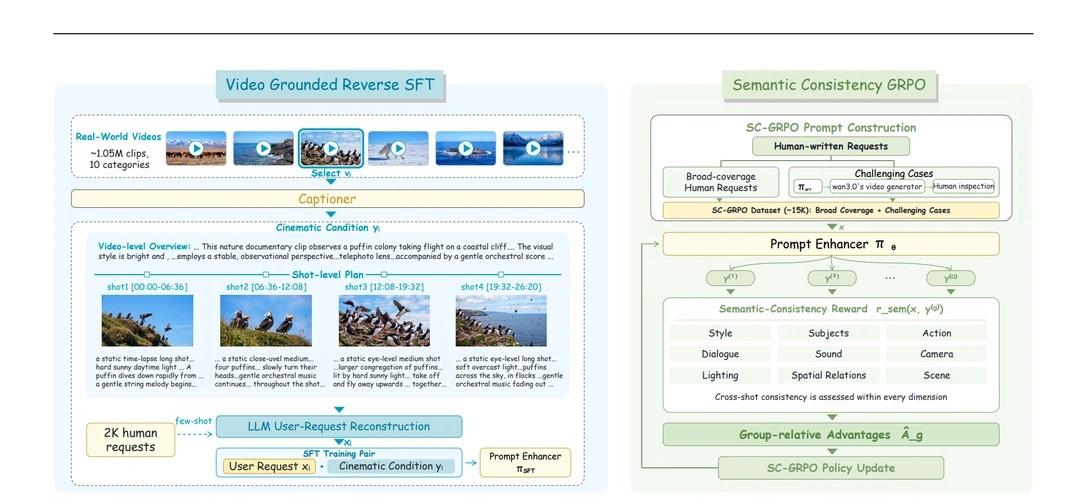
WanPE 反过来。团队先收集了约 105 万条真实视频,用多模态模型把这些视频还原成详细的 cinematic description,包括镜头、人物、动作、运镜、灯光、对白、音乐和音效。
然后再根据这些描述,反推出一条更接近普通用户会写的原始请求。
也就是:真实视频 → Cinematic Plan → 用户请求
训练时,再让 WanPE 学习从用户请求恢复这套视频规划。
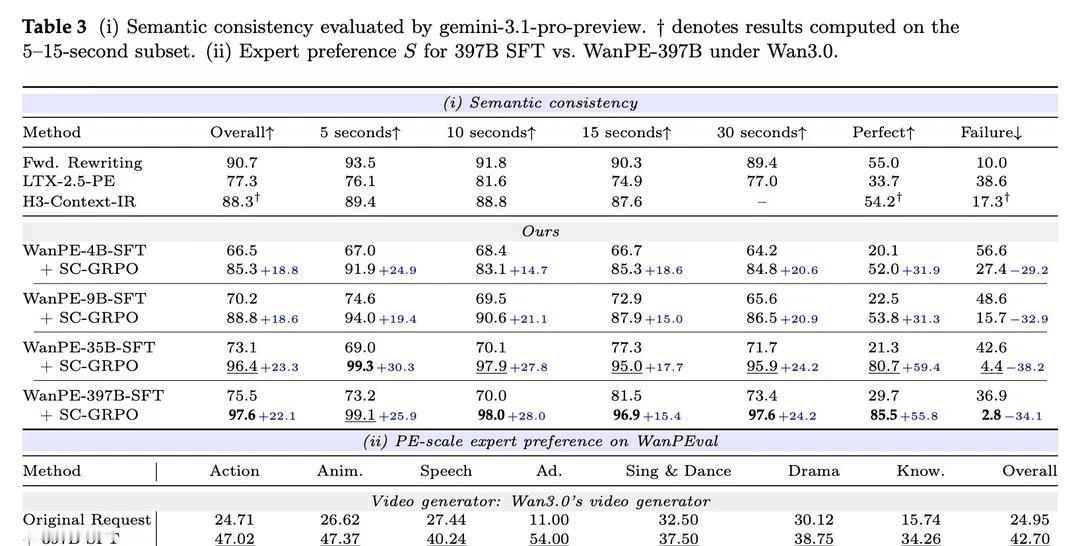
除了 SFT,WanPE 还做了一轮 SC-GRPO,主要解决长 Prompt 里的语义漂移。
比如人物属性被改了、台词串人、动作顺序错误,或者前后镜头出现冲突。
397B 版本做完 RL 后,语义一致性分数从 75.5 提升到 97.6,Failure 从 36.9% 降到了 2.8%。
另外一个比较明显的结果是:视频越长,Prompt Enhancement 越重要。
同一个 Wan3.0 视频生成器:
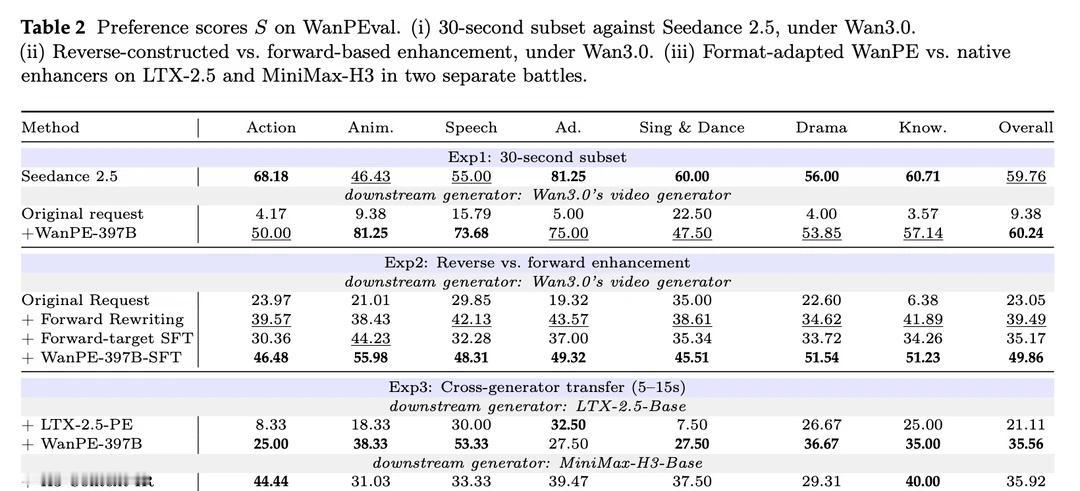
5 秒提升 10.66 分, 10 秒提升 16.28 分, 15 秒提升 18.84 分, 到了 30 秒,偏好分直接从 9.38 提升到 60.24。
所以 WanPE 虽然名字还是“提示词优化模型”,但它实际做的事情已经更接近一个 Cinematic Planner。
先理解用户想要什么,再把 30 秒视频拆成完整的镜头和时间线,最后交给视频生成器执行。
也就是说,长视频生成正在慢慢从:
Prompt → Video
变成:
用户需求 → 视频规划 → 分镜 / 时间线 → Video。
大模型 视频生成 Wan